Tanguy Mombert · Ingénieur IA junior

Bonjour

Voici mes 3 derniers projets IA.

Projet 01 · Agents IA, Machine Learning

Des agents IA qui construisent un détecteur d'ajouts de montage

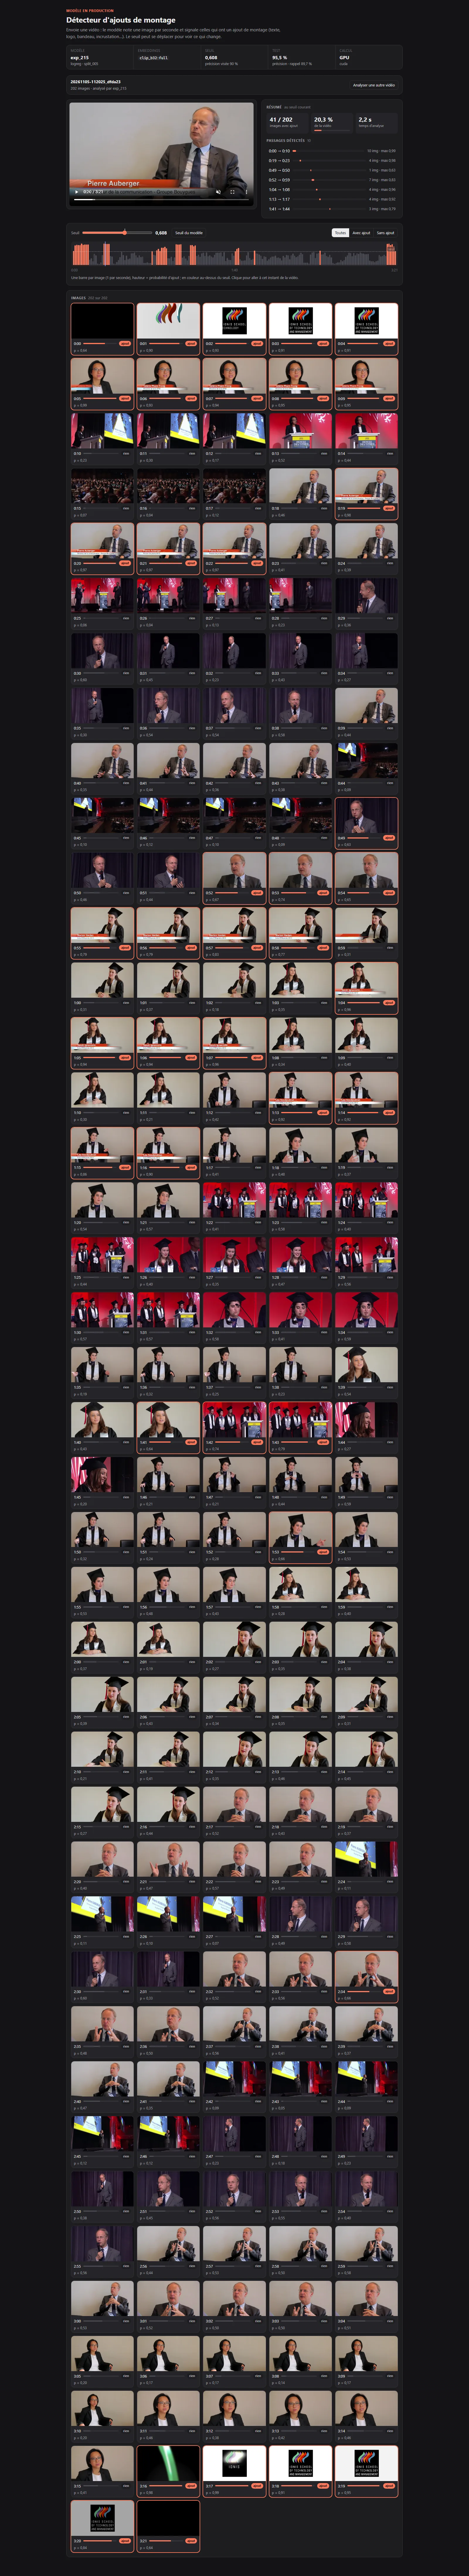
Un pipeline multi-agents construit un classifieur d'images : cette image est-elle brute, ou contient-elle un ajout au montage quelconque ?
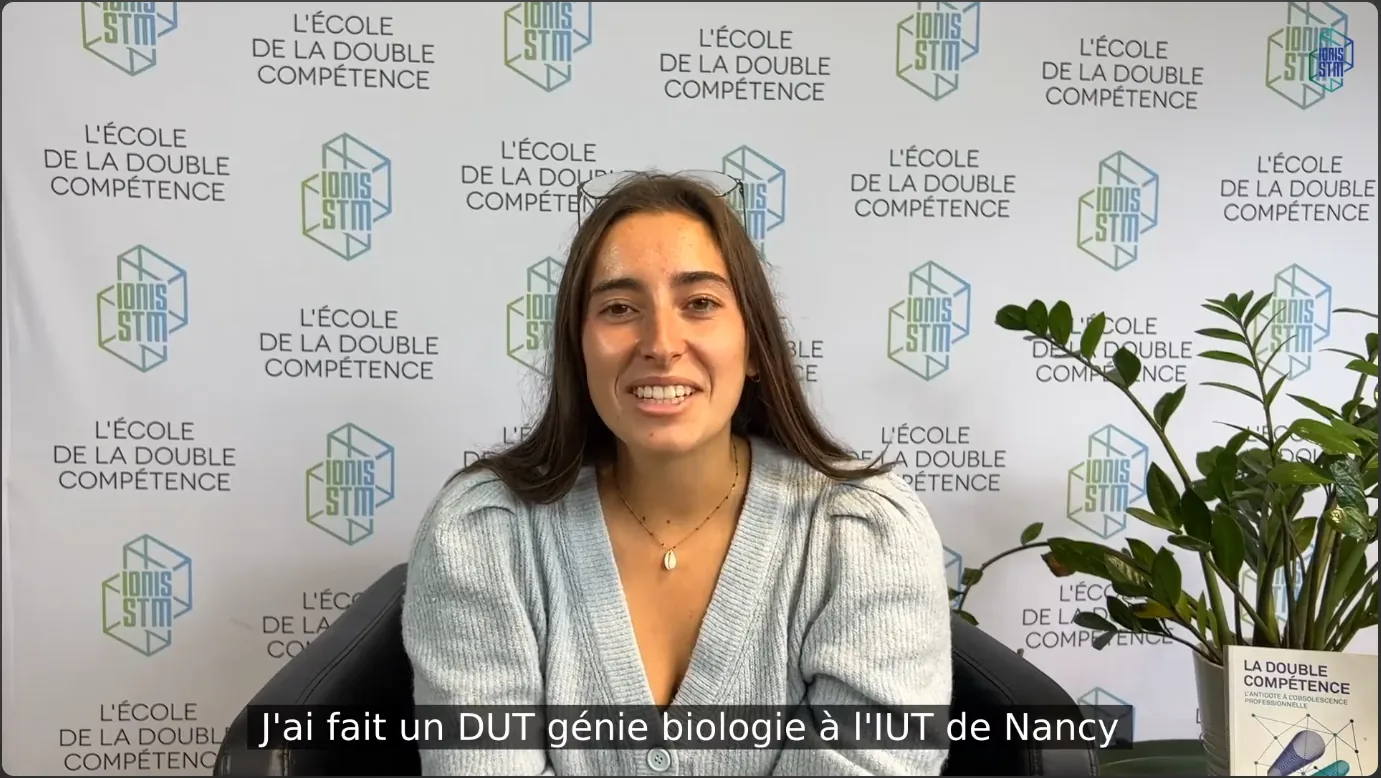
(sous-titres, logo, mots clés, chapitres...)

Objectifs

  • Améliorer le RAG du projet 02 et détecter les mots-clés.
  • N'envoyer en OCR que les images avec ajout, pour réduire les coûts.

Statistiques actuelles sur 75 vidéos

Précision
95,5 %
Rappel
89,7 %
Test
chaînes jamais vues
Validation croisée
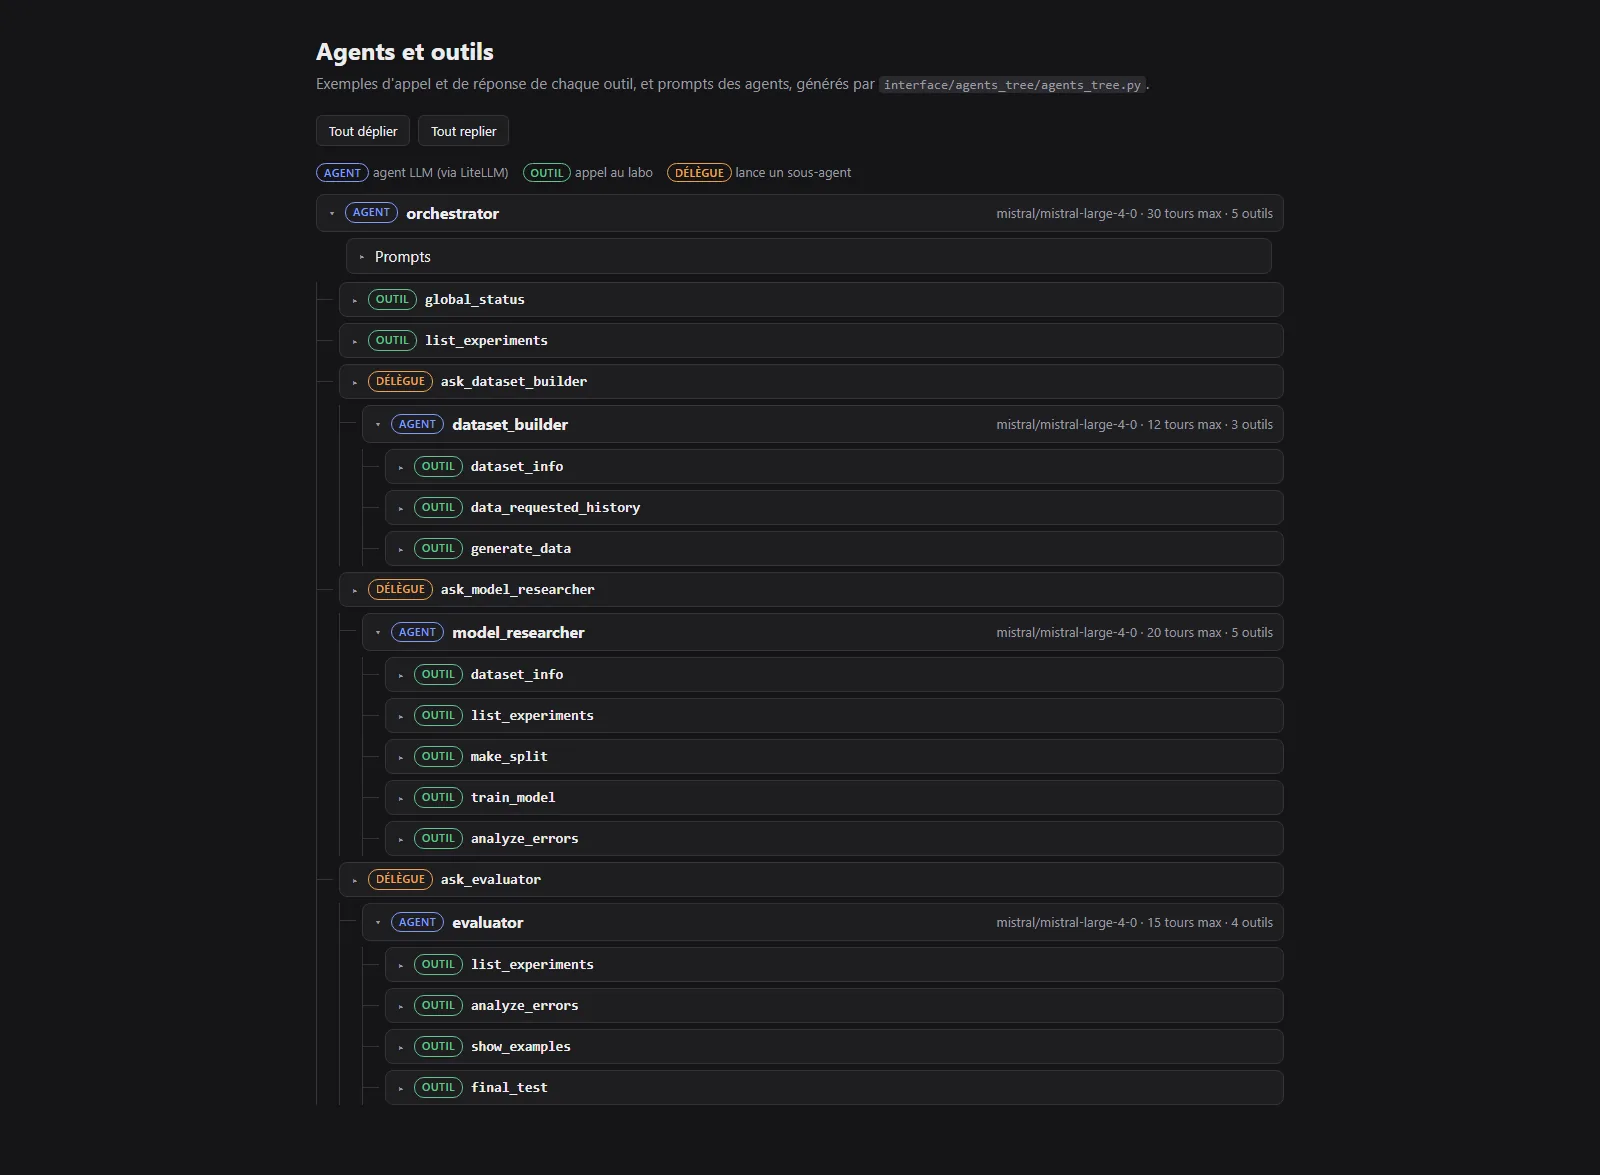
  • Agents. Un orchestrateur délègue à un Dataset Builder, un Model Researcher et un Evaluator, puis décide du cycle suivant à partir de leurs rapports.
  • Annotation. Des vidéos YouTube sont annotées image par image par 3 LLM de vision, en API batch. Une image n'est gardée que si les trois sont unanimes.
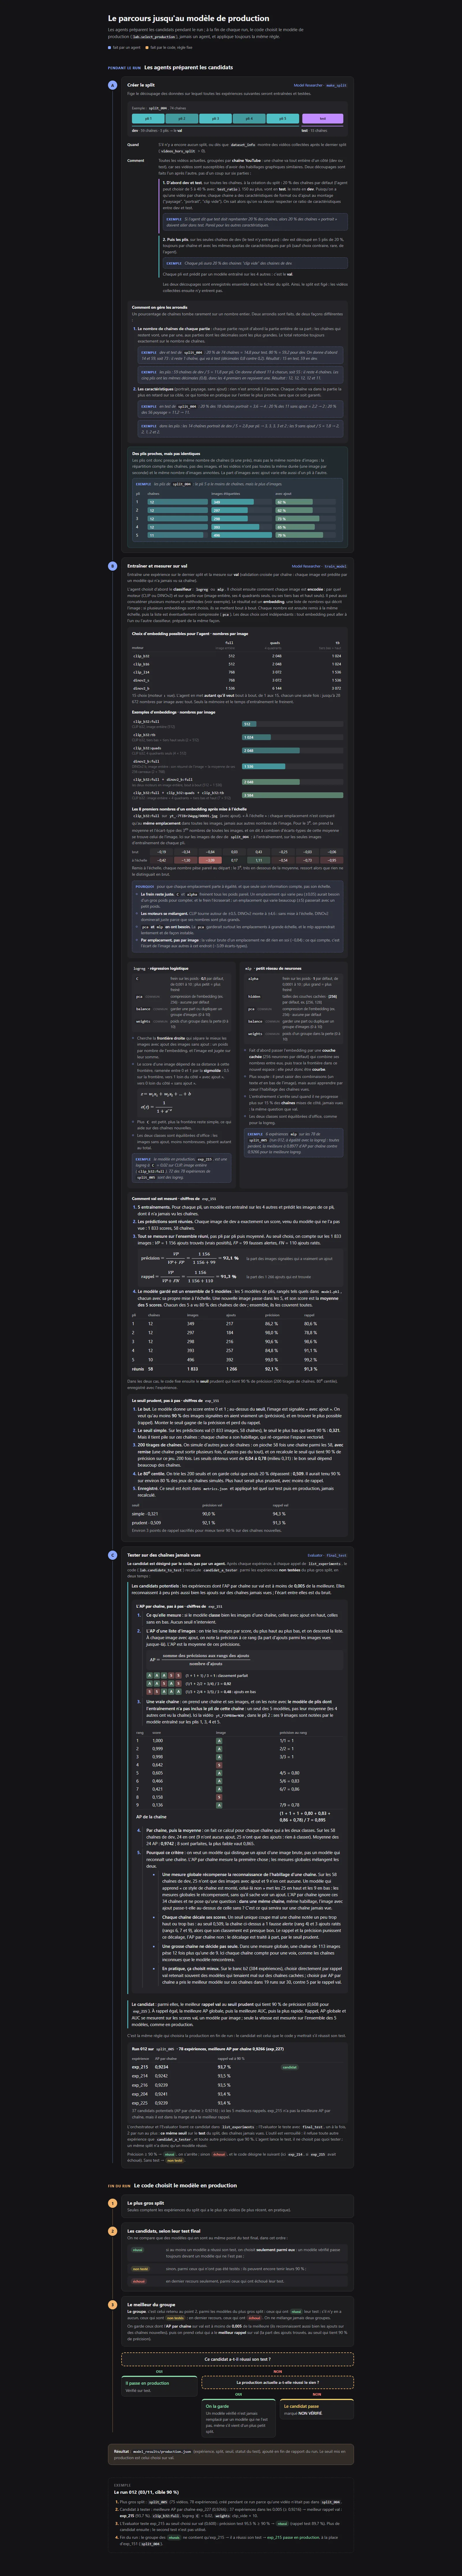
  • Garde-fous. Aucun agent ne met de modèle en production : le code choisit parmi les expériences qui ont réussi leur test final.
  • Banc d'essai. Un banc compare les LLM qui pilotent les agents, sur un instantané figé du dataset et des chaînes cachées aux agents.
  • Python
  • LiteLLM
  • CLIP
  • DINOv2
  • API batch
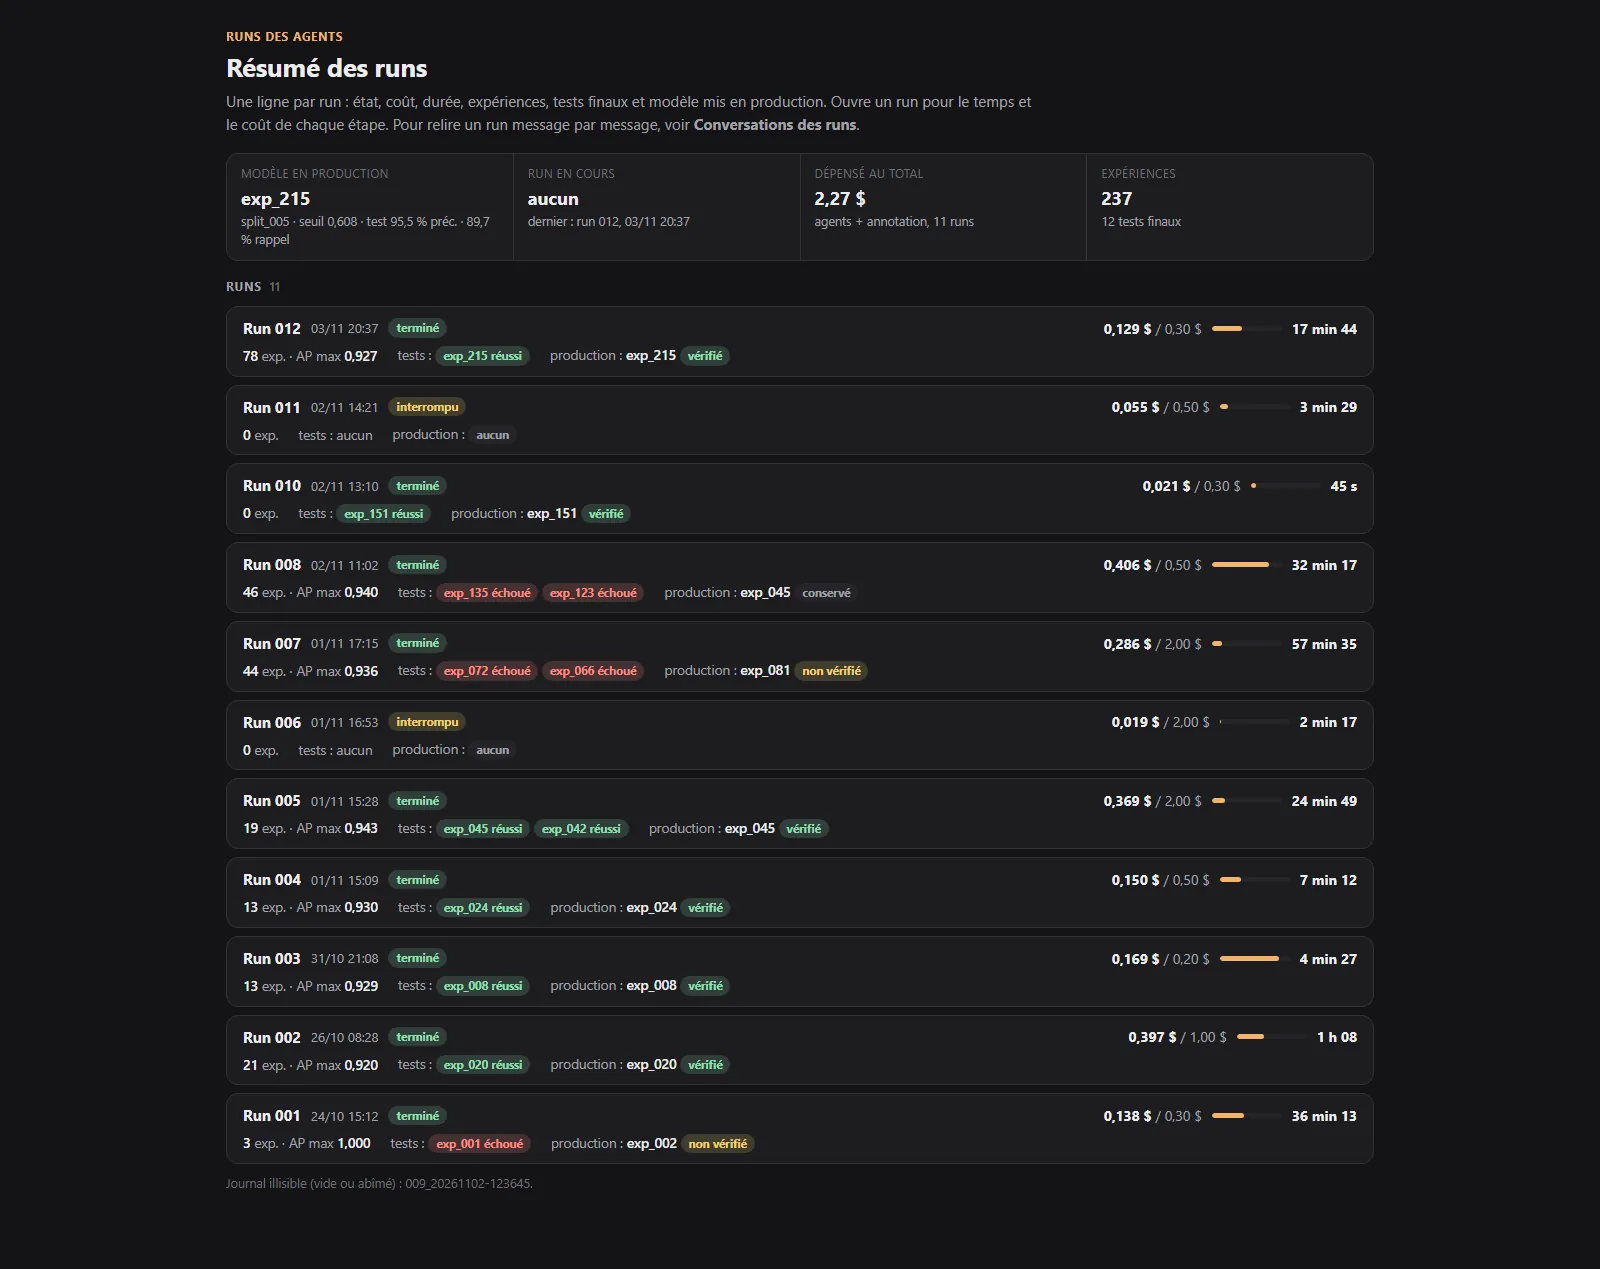
Résumé des runs : état, coût, durée, expériences, tests finaux et modèle mis en production.
Modèle en production : on envoie une vidéo et on voit les images où le classifieur détecte un ajout, avec un seuil réglable.
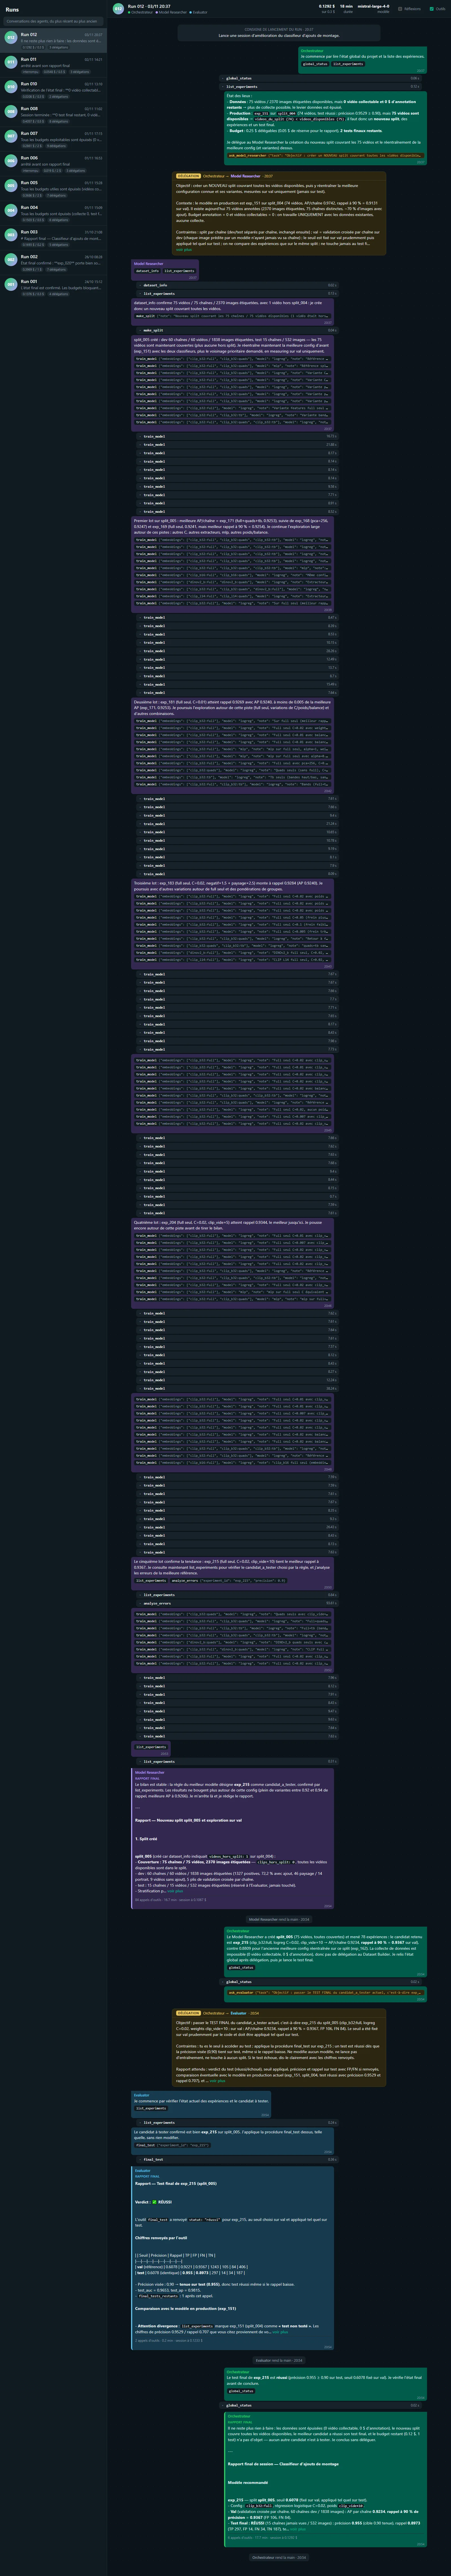
Conversations des runs : chaque run se relit comme une discussion entre les agents.
Agents et outils : l'arbre des agents, ce que reçoit chaque modèle et des exemples d'appels réels.
Le parcours jusqu'au modèle de production : du split créé par les agents au modèle choisi par le code.
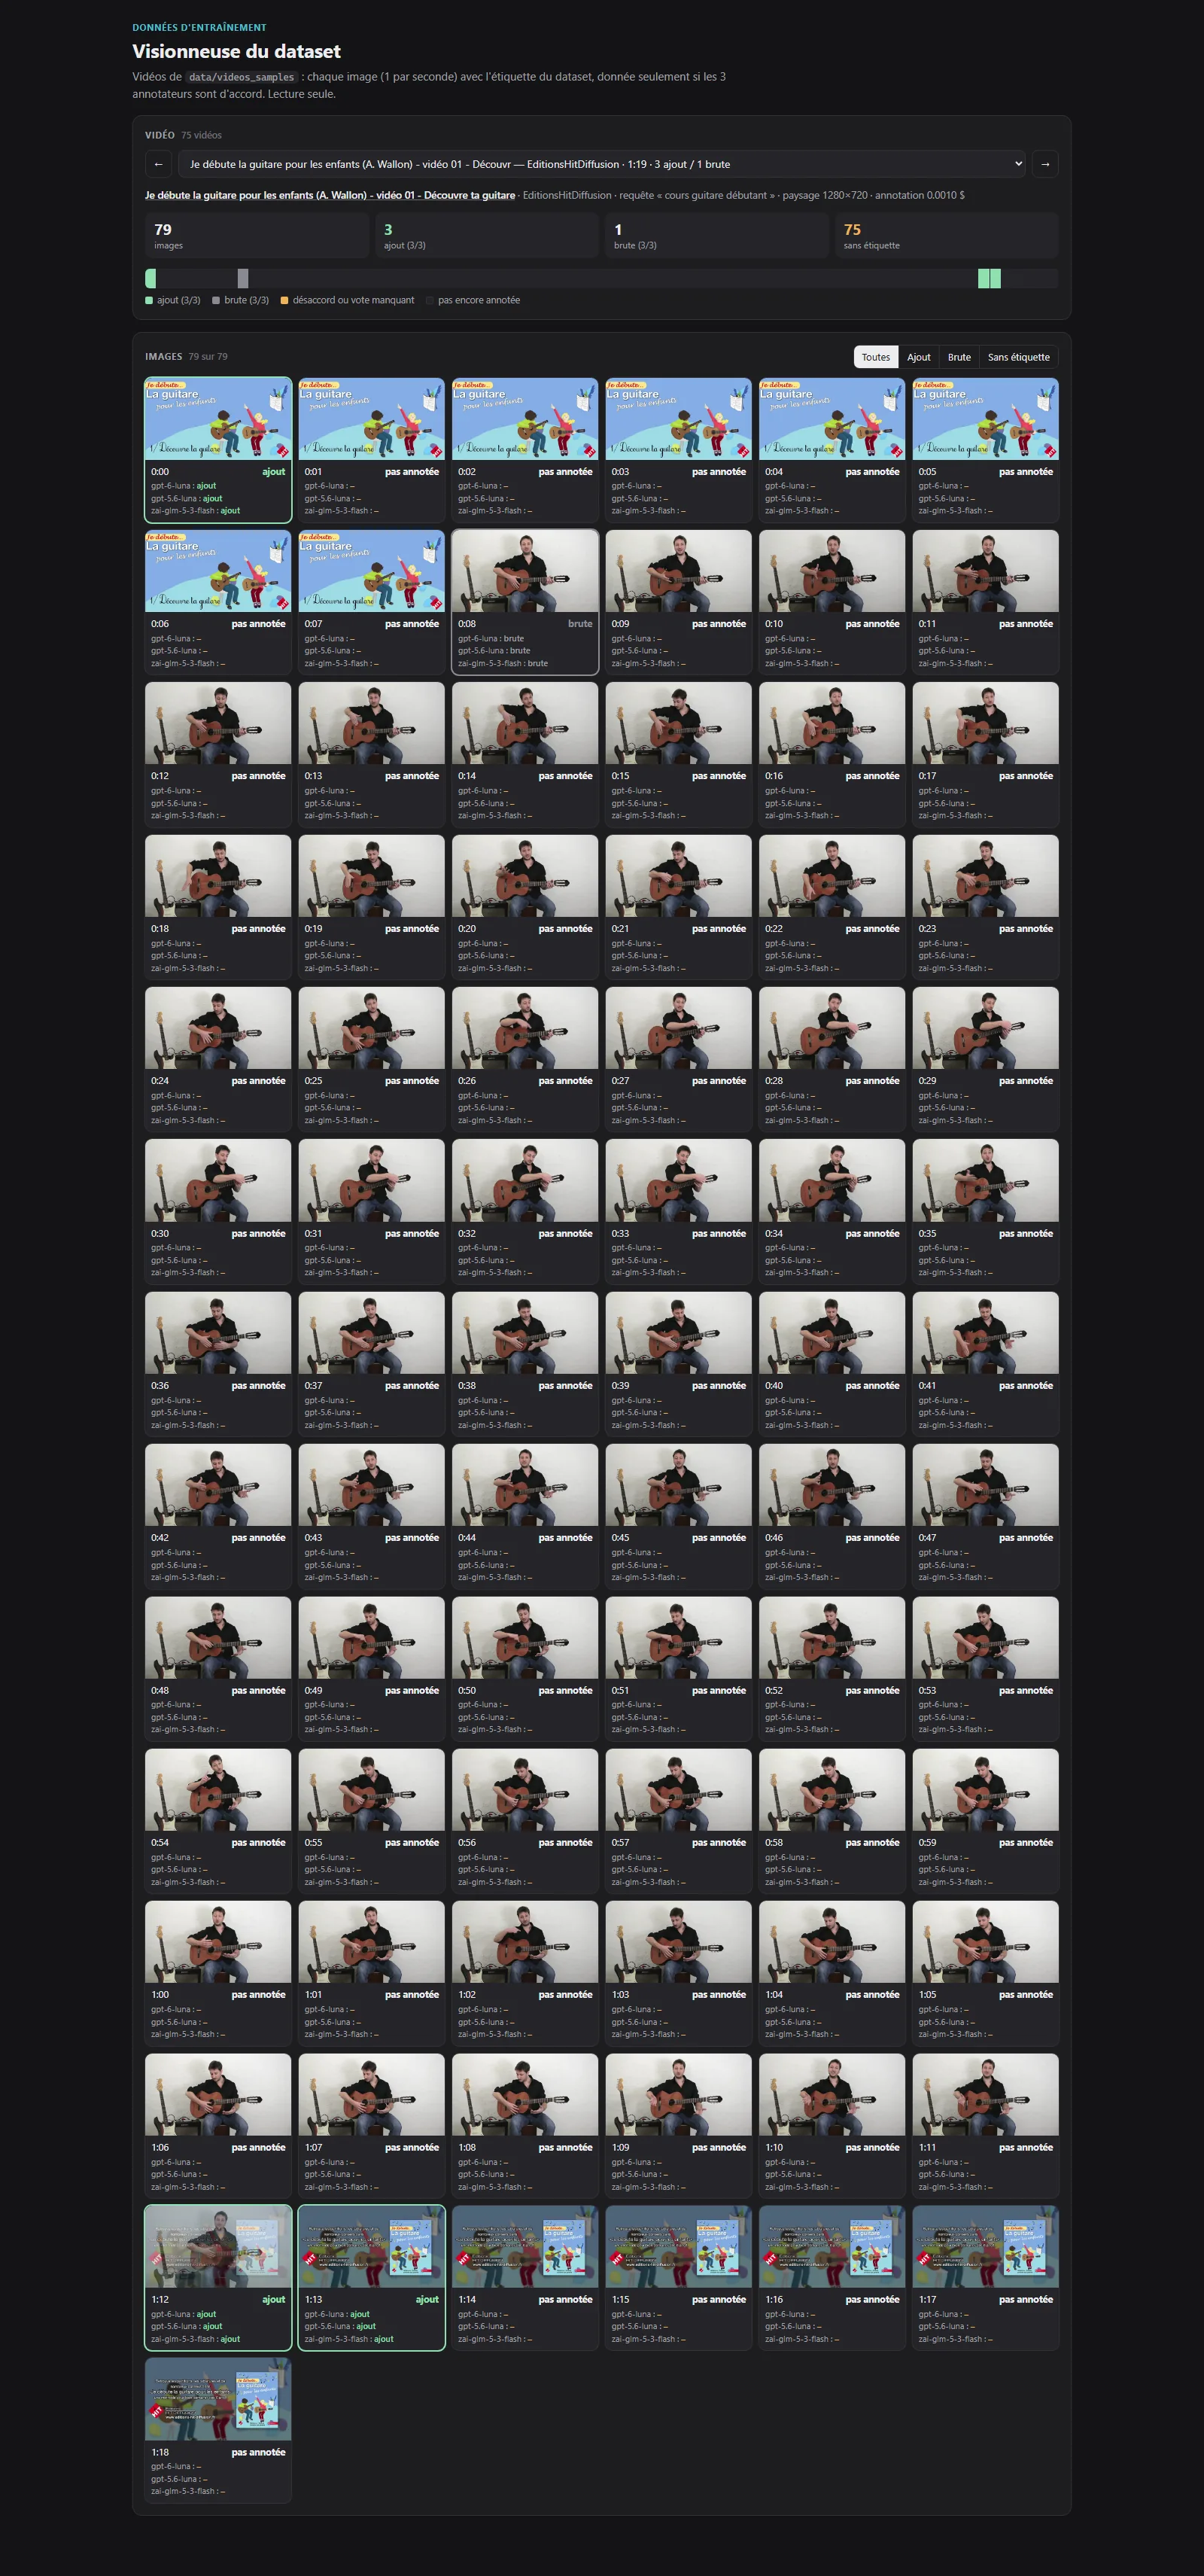
Visionneuse du dataset : étiquette et votes des trois annotateurs pour chaque image.
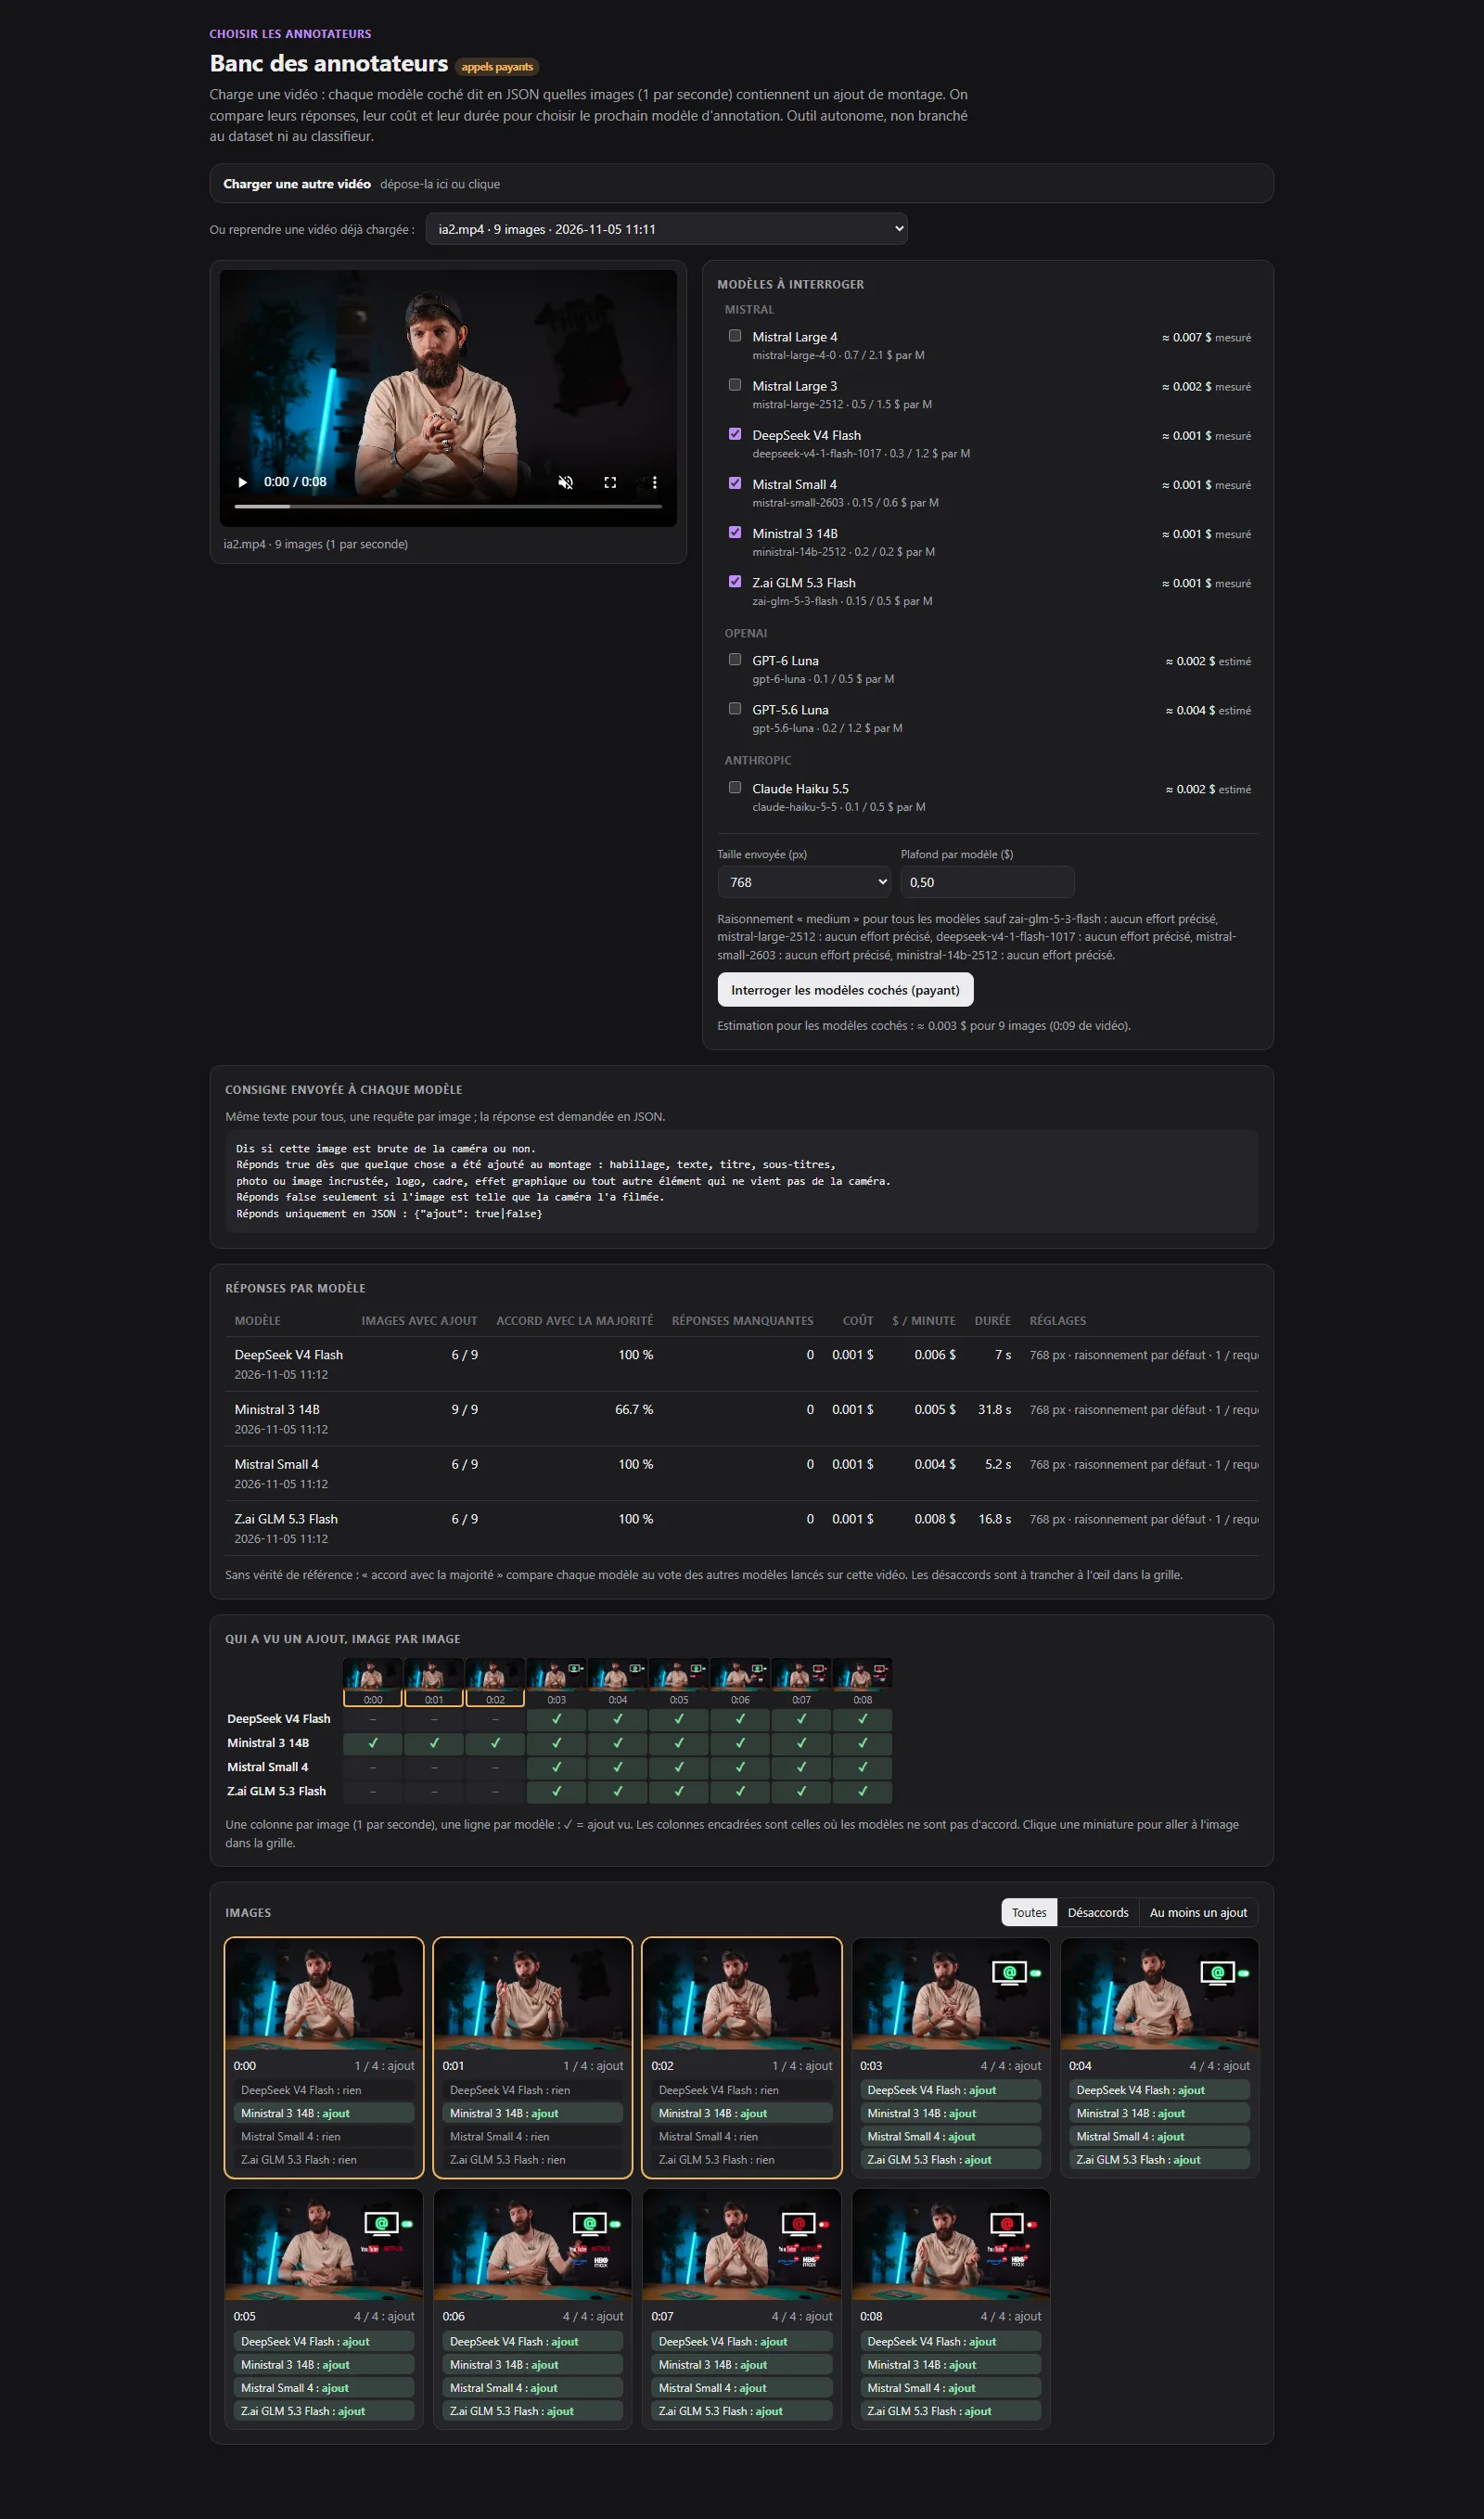
Banc des annotateurs : comparaison des réponses, du coût et de la durée des LLM annotateurs.
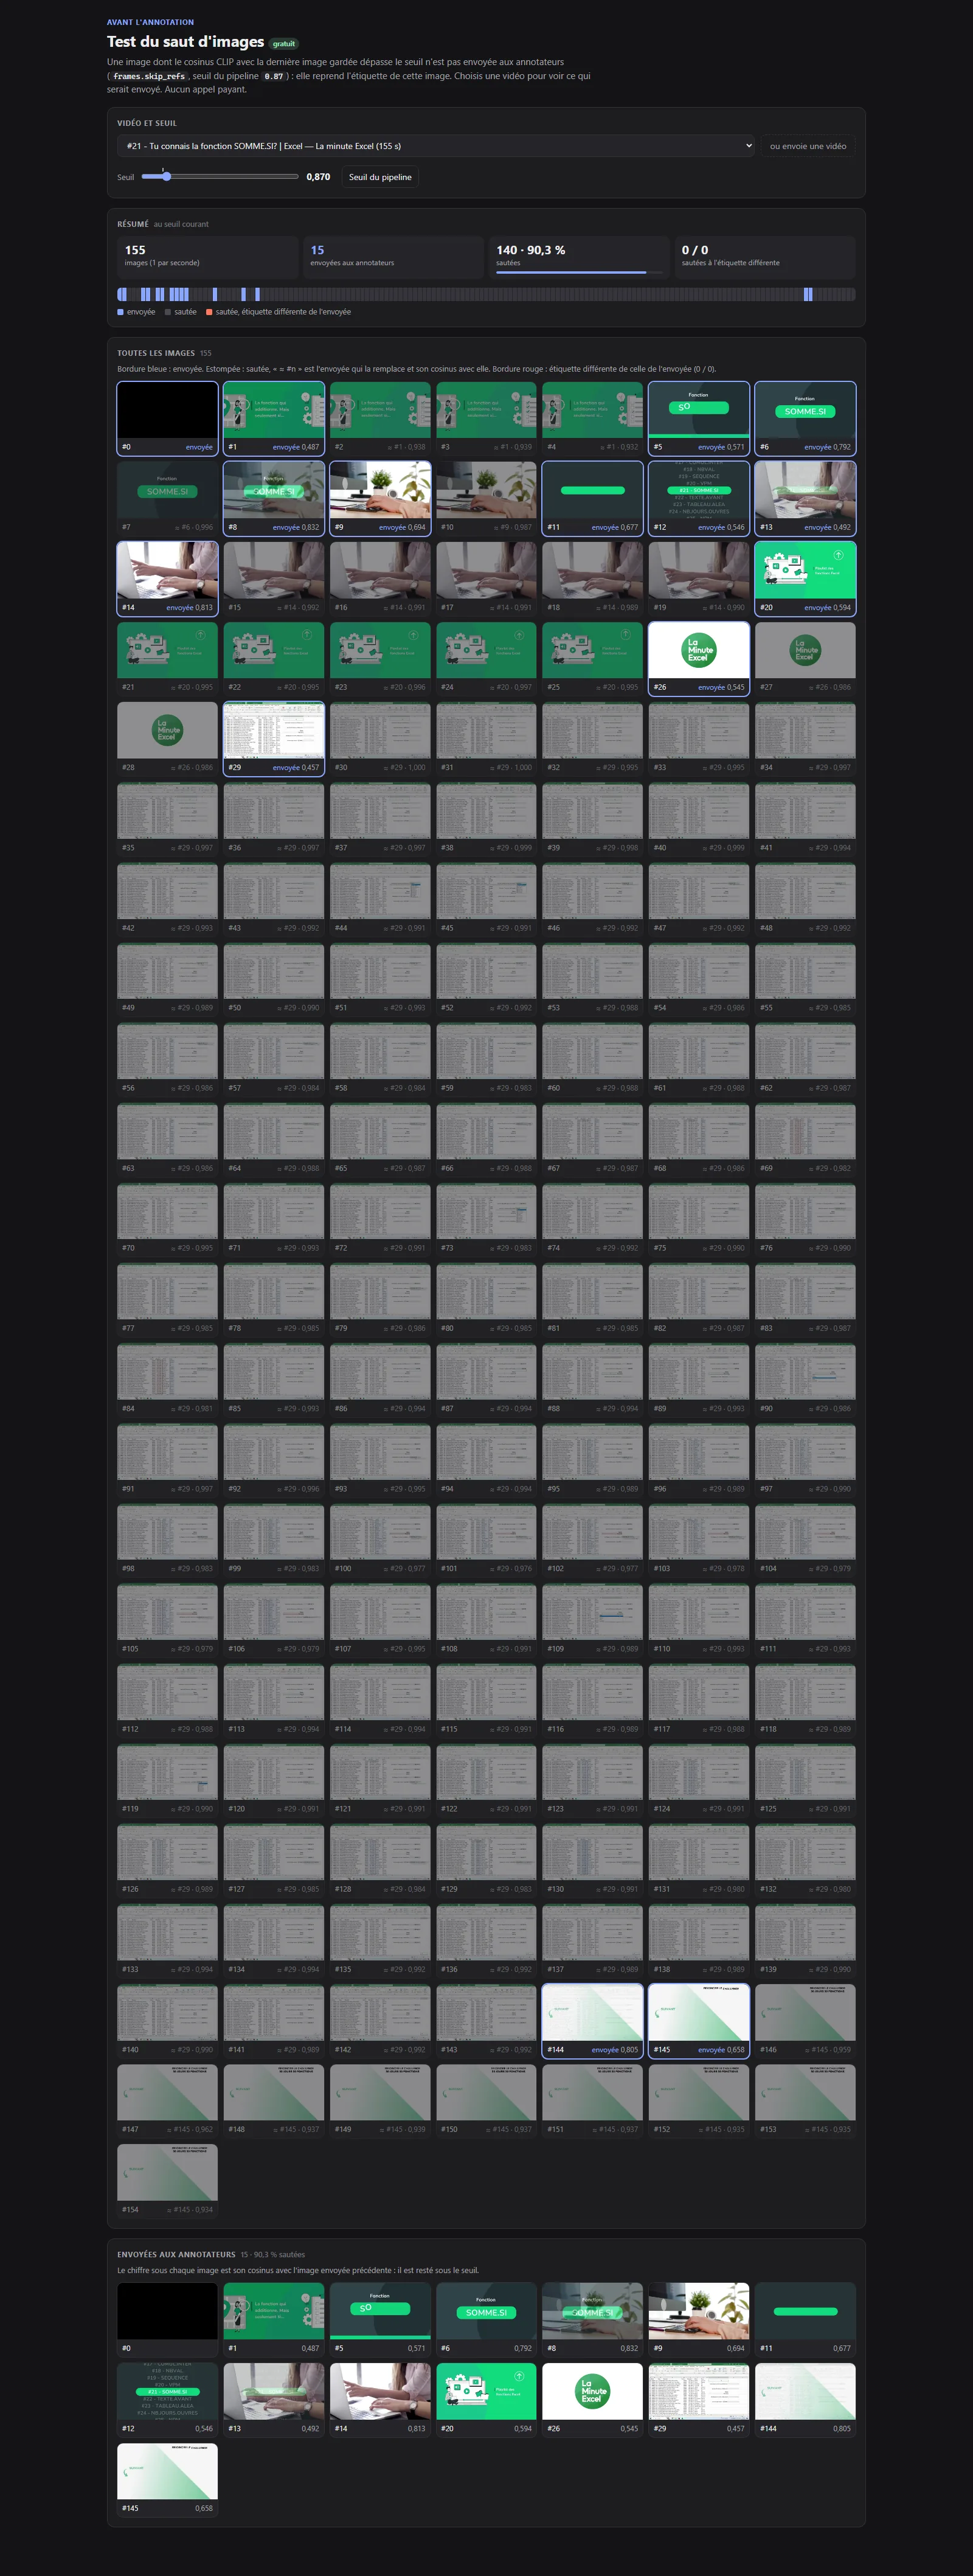
Test du saut d'images : celles envoyées aux annotateurs et celles sautées comme quasi identiques.

Projet 02 · LLM Engineering, RAG

RAG sur les vidéos YouTube de l'école IONIS-STM

Un assistant en ligne répond aux questions sur le contenu et les statistiques des vidéos de la chaîne.

Statistiques actuelles

Recall vidéos
88 %
Coût moyen
0,0063 $ par question
Évaluation
75 questions
Latence
P50 P75 P90 P95
Premier token 3,17 s 3,72 s 4,11 s 4,95 s
Réponse prête 3,74 s 4,51 s 5,33 s 5,68 s
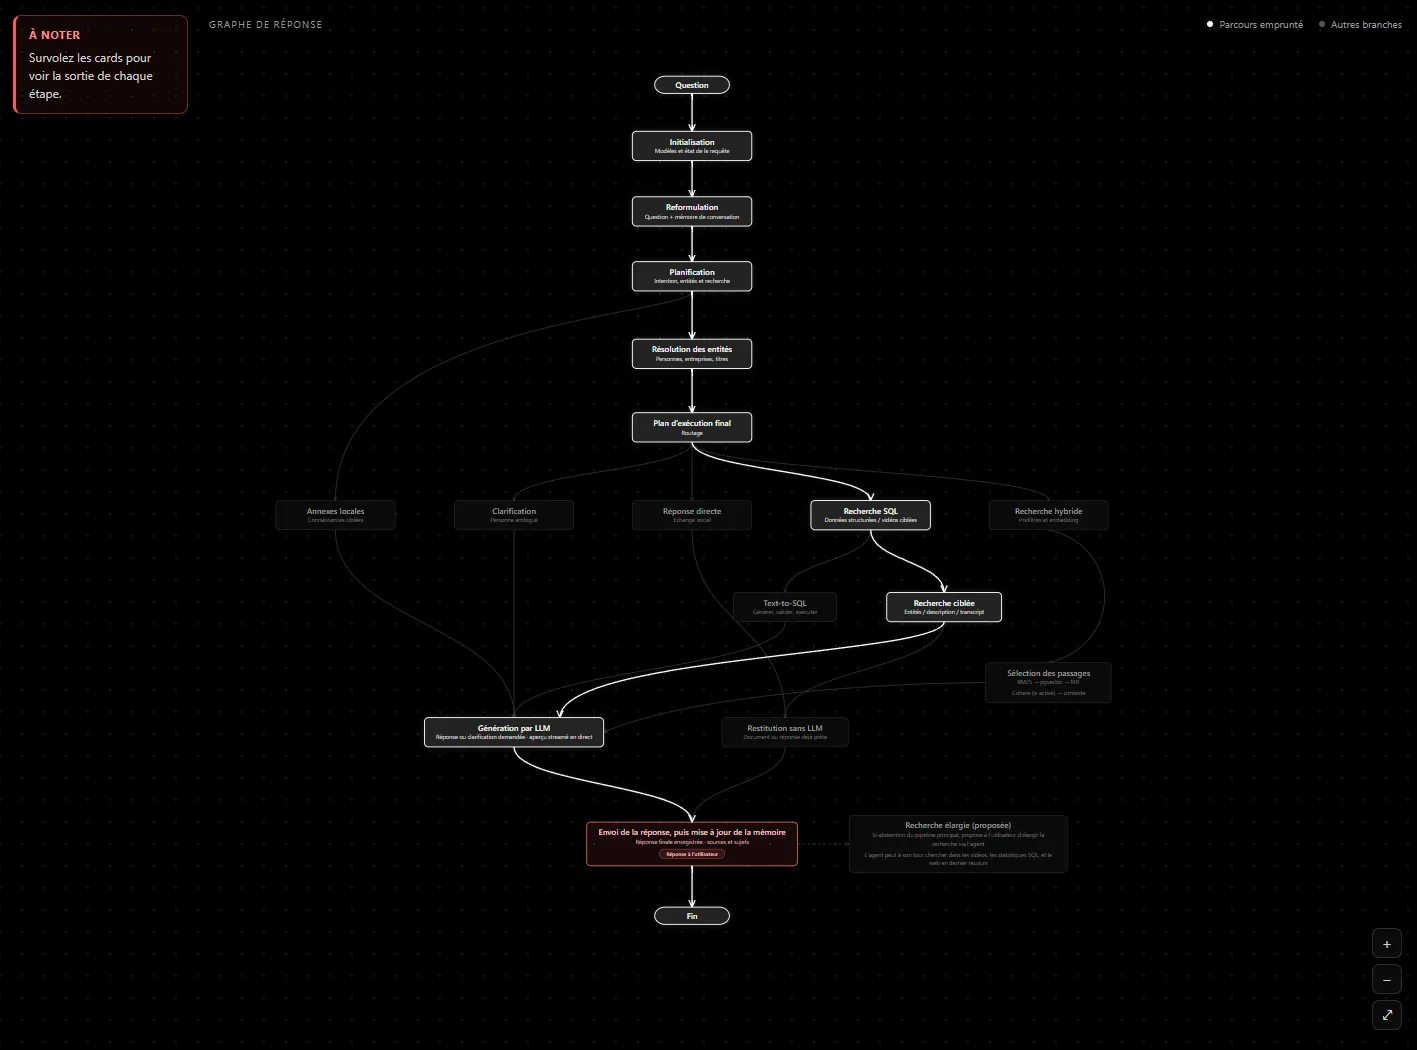
  • Recherche hybride. Full-text PostgreSQL, vectorielle avec pgvector, fusion RRF, puis reranking Cohere. Le modèle d'embedding et la taille des vecteurs ont été choisis par un banc sur 45 questions annotées. Voir le pipeline de réponse →
  • Recherche chiffrée. Une route Text-to-SQL répond aux questions chiffrées. Le pipeline tourne sur LangGraph, avec un agent autonome Mistral.
  • Agent de secours. En cas d'échec, un agent prend le relais.
  • Préparation des vidéos. Création d'un pipeline de traitement automatisé pour obtenir le maximum d'informations utiles (sous-titres, questions posées, type de vidéo, identification des speakers...). Création d'un petit modèle de régression logistique pour aider à identifier les types de vidéos. Voir le pipeline de préparation →
  • Déploiement. Docker, Caddy et GitHub Actions, sur Scaleway (VM GPU, stockage objet) et un VPS Infomaniak.
  • LangGraph
  • PostgreSQL
  • pgvector
  • Cohere
  • Mistral
  • WhisperX
  • Phoenix
  • Docker
Graphe complet du pipeline de réponse RAG, avec le parcours de la question éclairé
De la question à la réponse.
Le pipeline relie une prise de parole à son intervenant et à son timecode.
L'OCR permet de conserver une question visible, même sans voix dans la vidéo.
Les sous-titres apportent un second signal pour corriger un mot mal entendu.
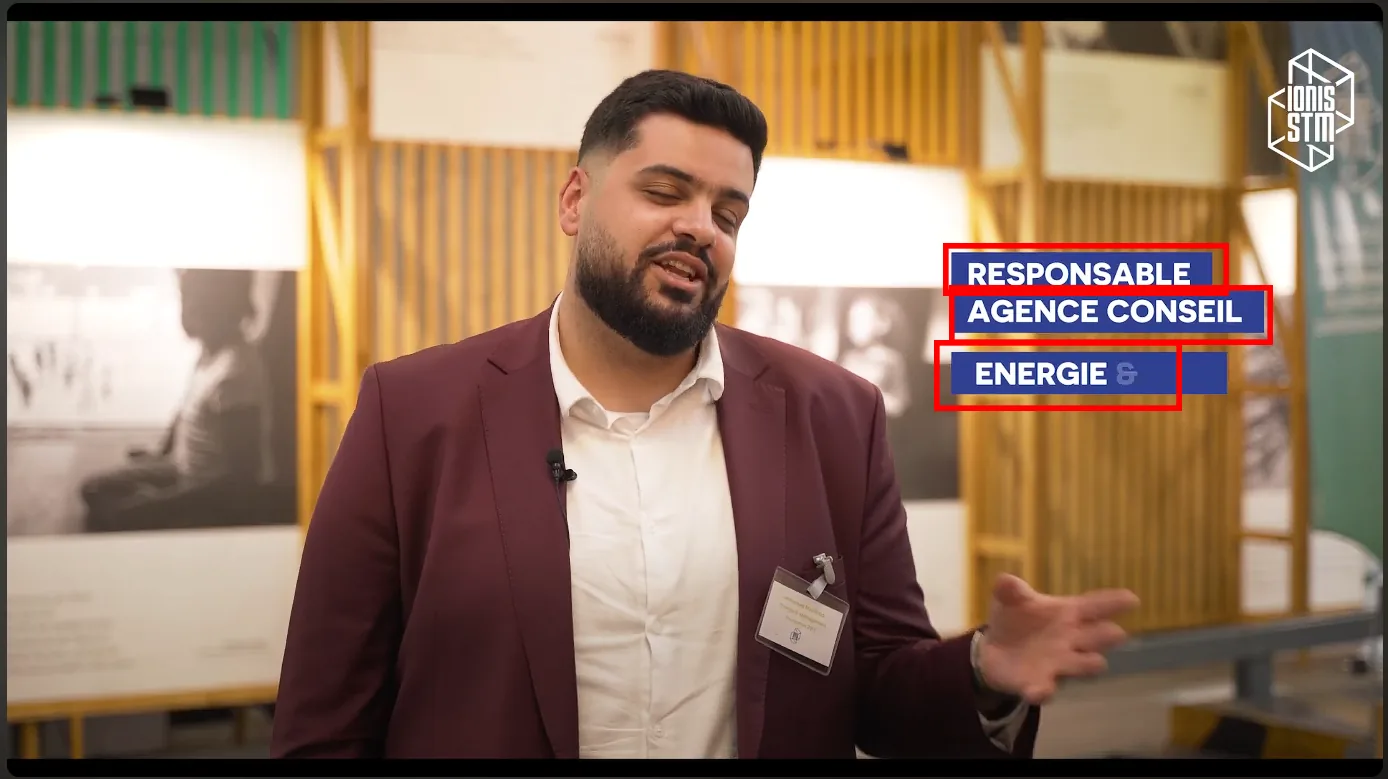
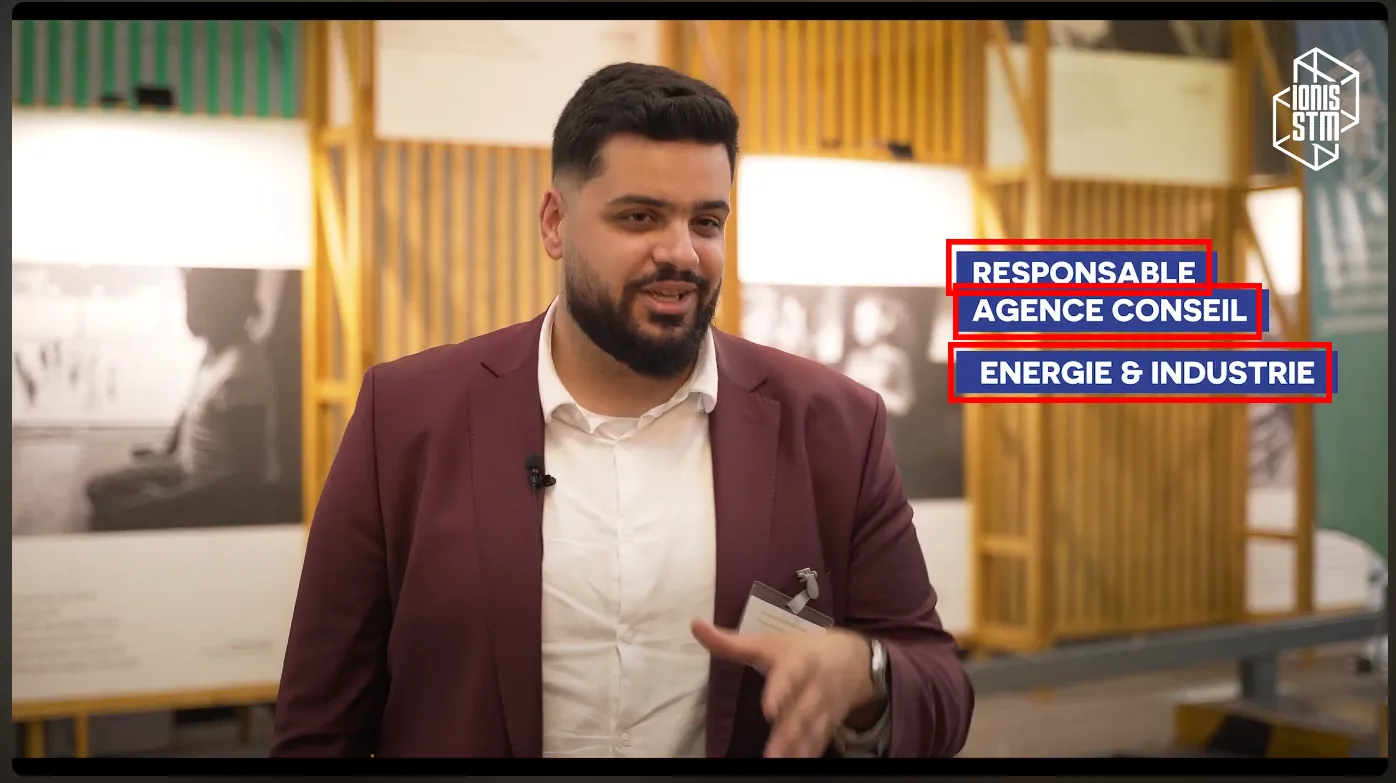
Un cartouche à l'écran peut préciser le nom ou le rôle d'un intervenant.
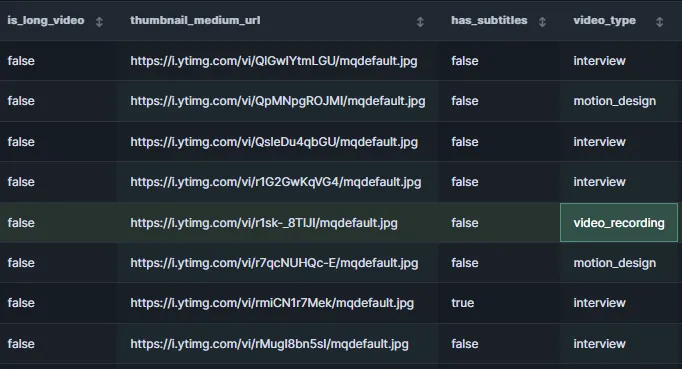
Le pipeline identifie le format de la vidéo pour adapter son traitement.
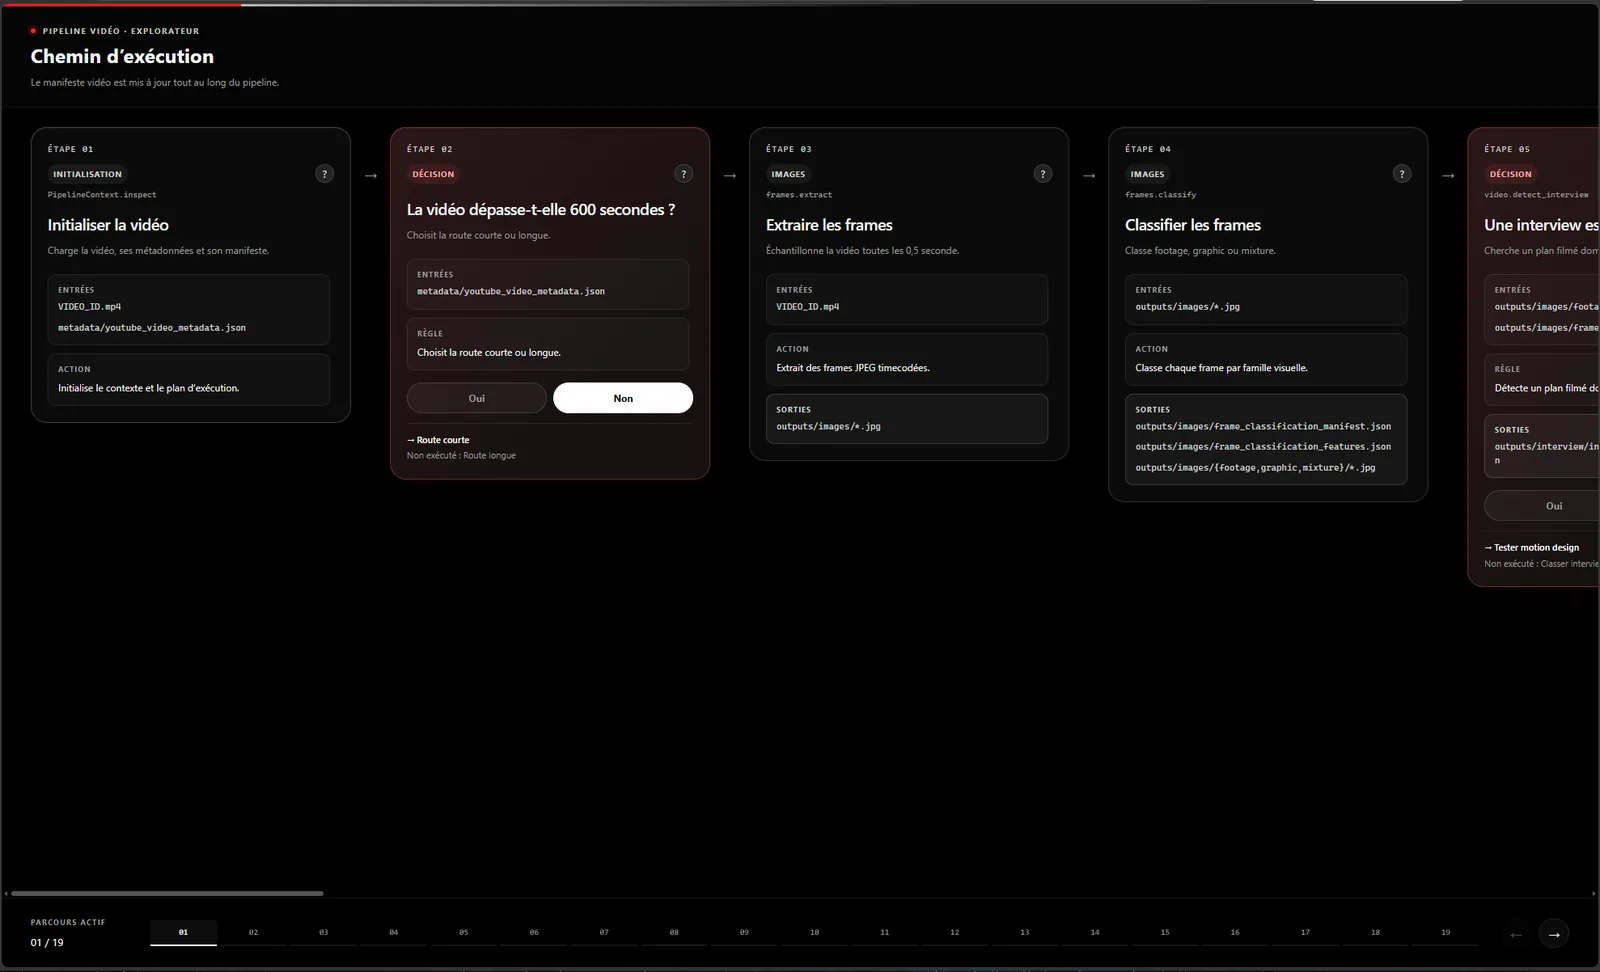
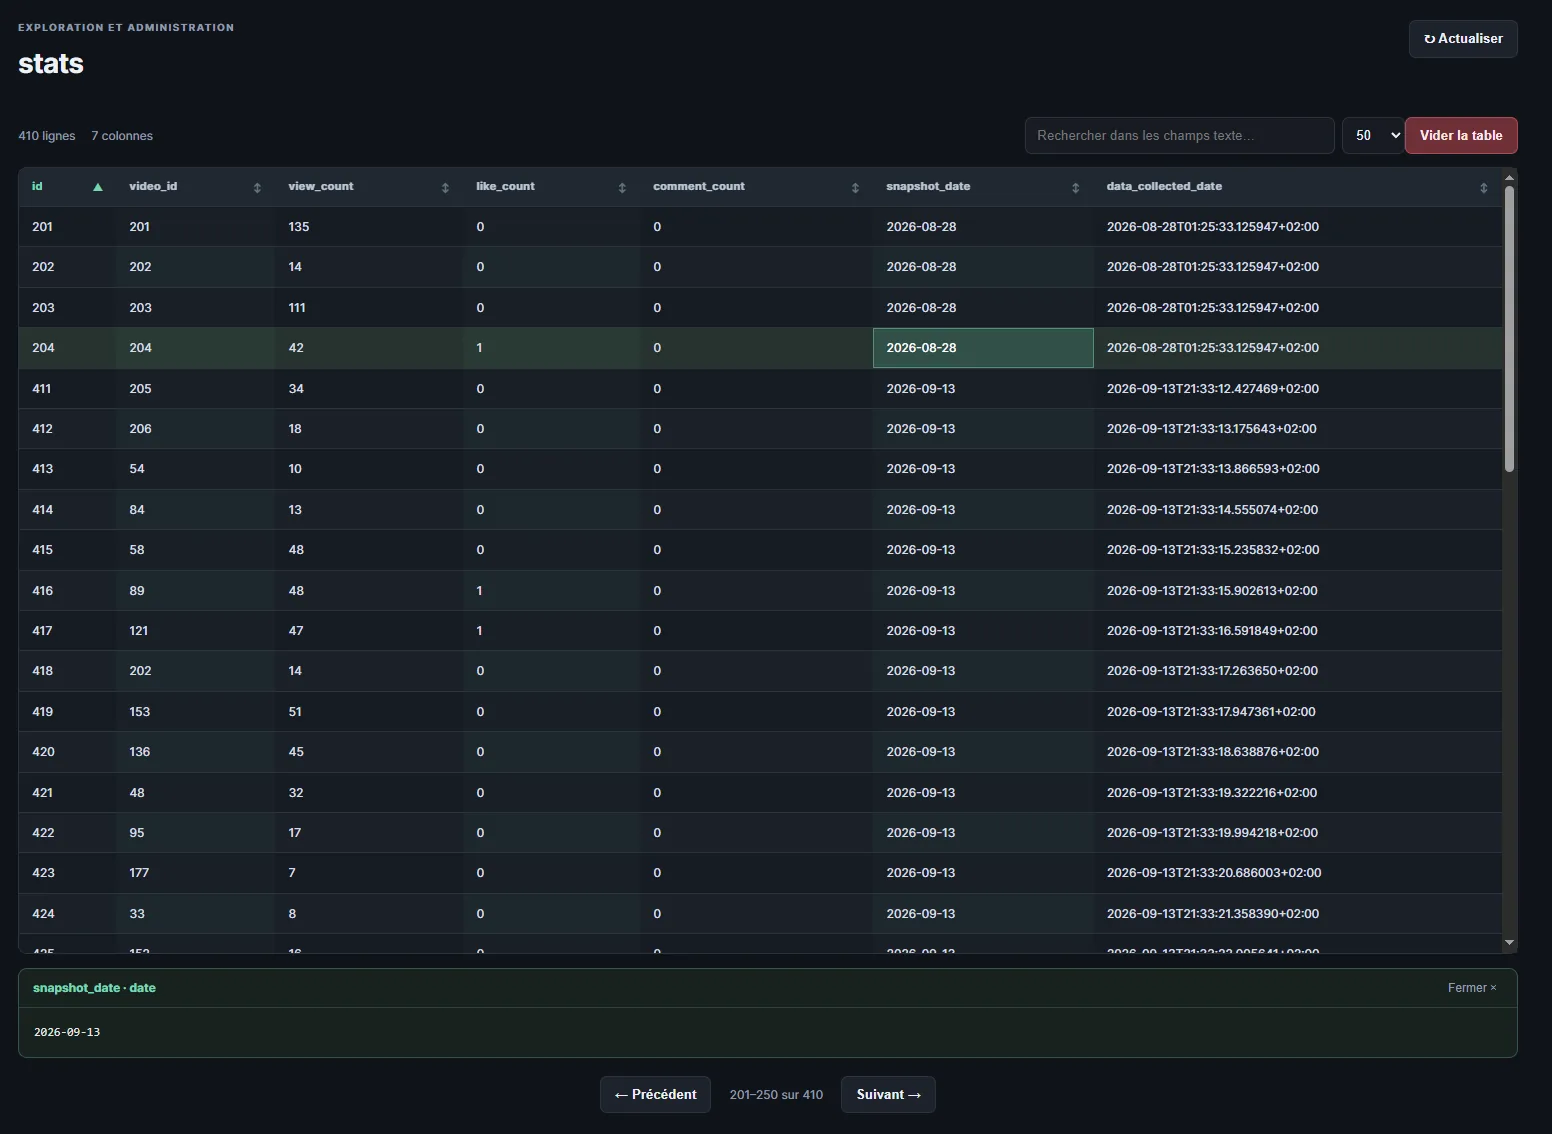
Aperçu de l'explorateur du pipeline de préparation des vidéos
Aperçu de l'explorateur du pipeline de préparation.
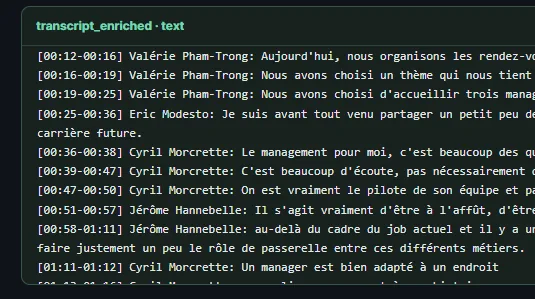
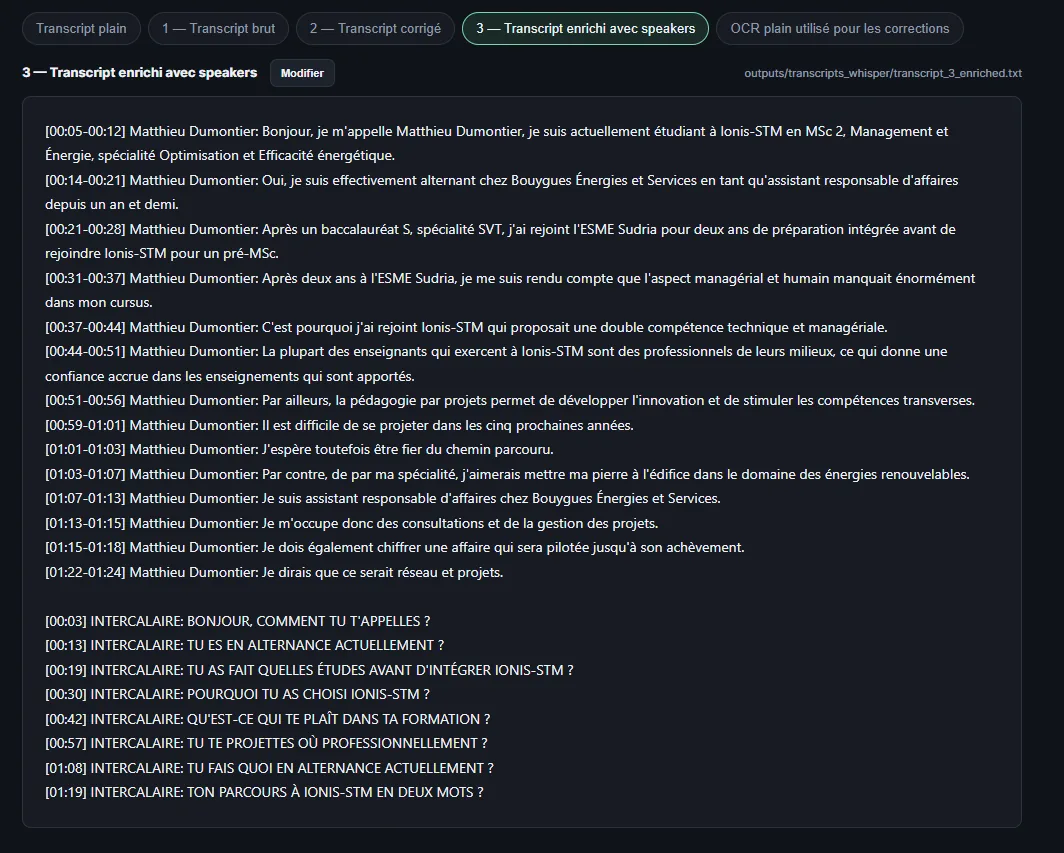
Exemple de transcript enrichi avec timecodes, speakers et questions posées
Exemple de transcript enrichi (timecodes, speakers, questions posées).
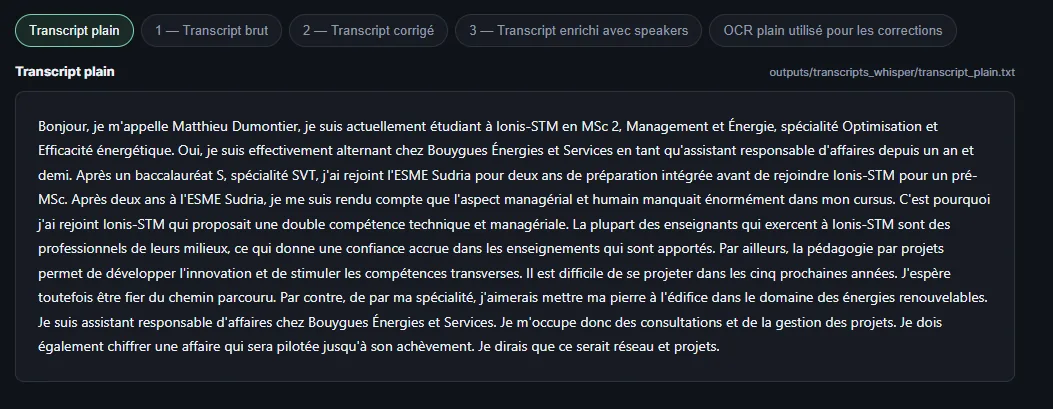
Exemple de transcript classique découpé en chunks
Exemple de transcript classique, celui qui est découpé en chunks.
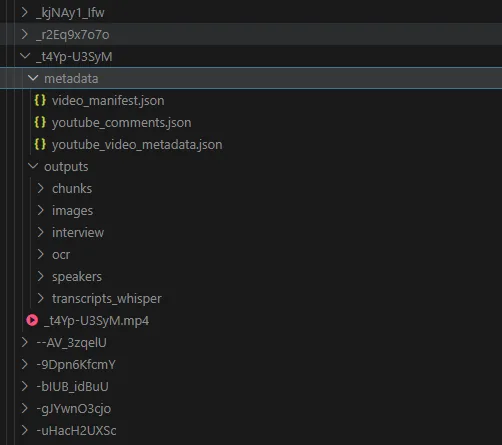
Exemple d'organisation des artefacts d'une vidéo
Exemple d'artefacts produits pour une vidéo.
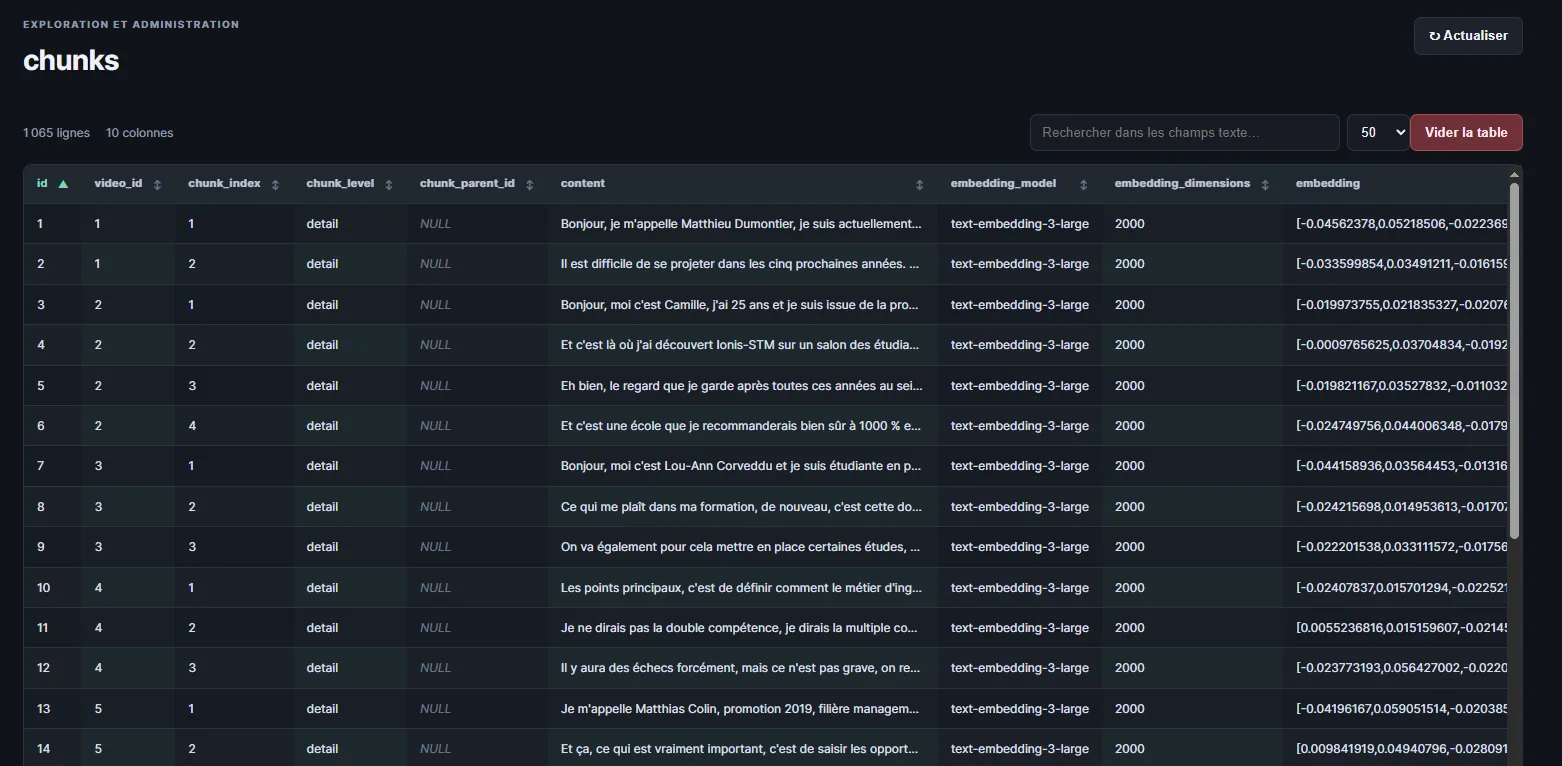
Exemple de table PostgreSQL contenant les chunks et leurs embeddings
Exemple de table PostgreSQL pour les chunks et embeddings.
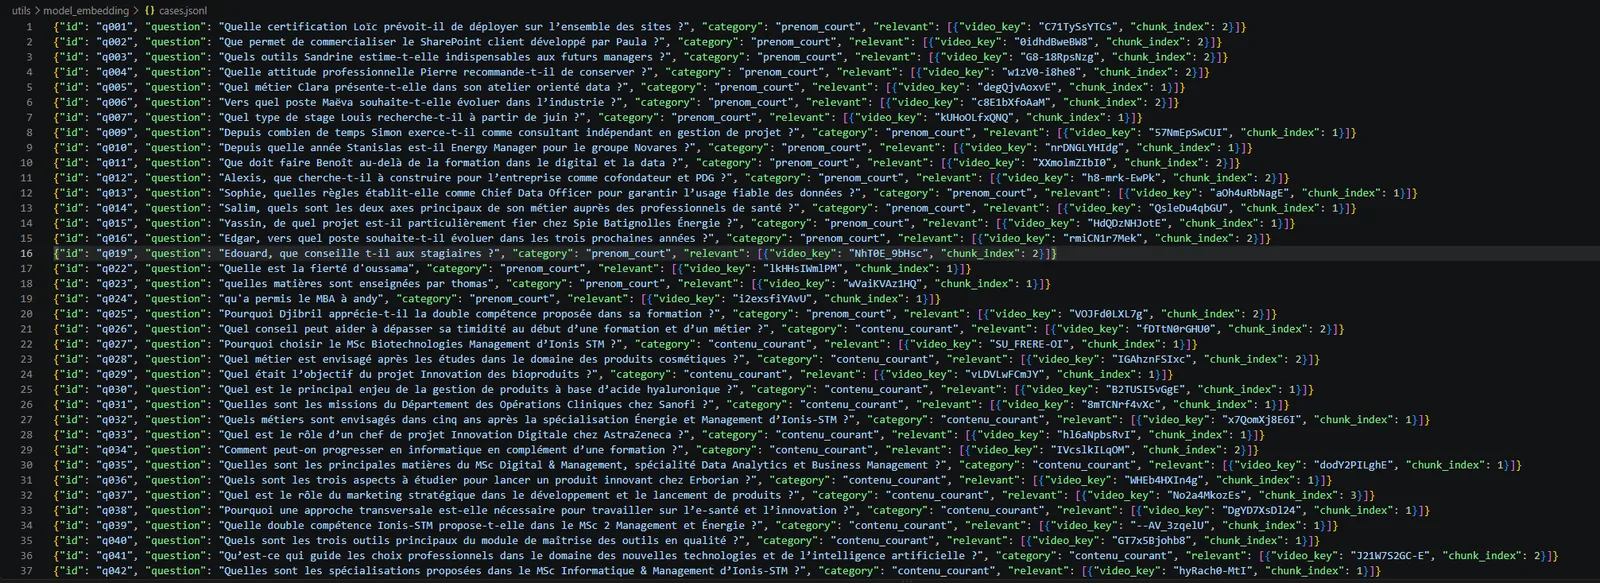
Exemples de cas de test utilisés pour évaluer les embeddings
Exemples de questions utilisées pour le test.
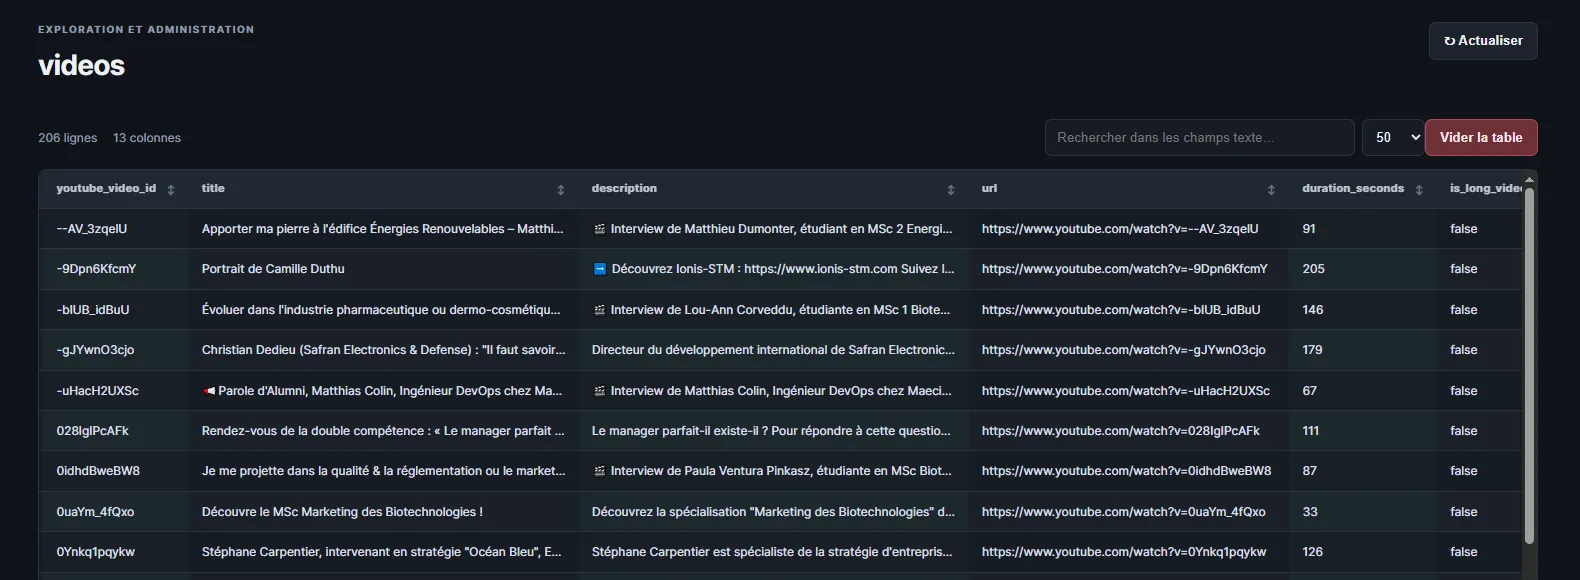
Exemple de table PostgreSQL contenant les métadonnées des vidéos
Exemple des métadonnées des vidéos enregistrées dans PostgreSQL.
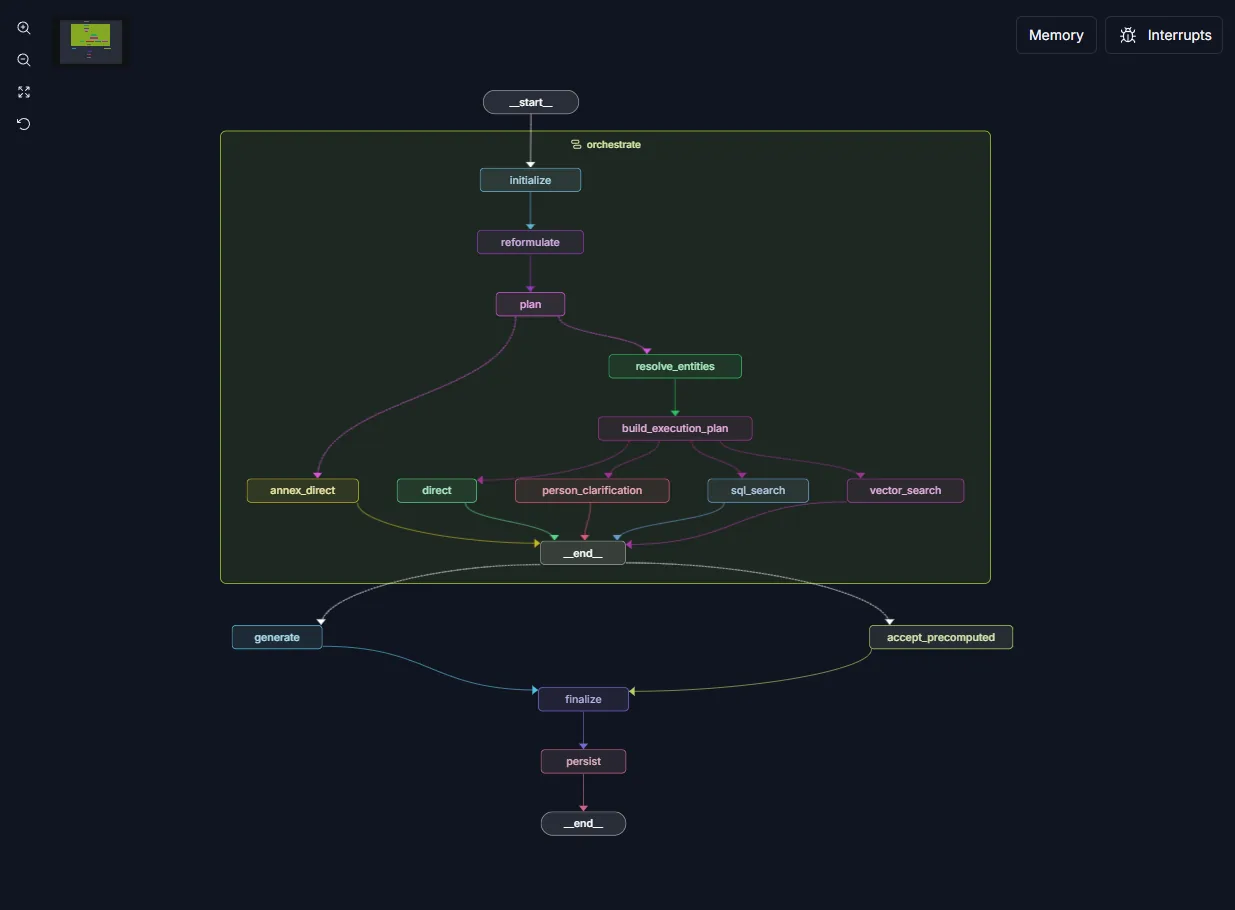
Graphe LangGraph du pipeline de réponse dans LangSmith Studio, avec le sous-graphe de recherche déplié
Le graphe LangGraph complet dans LangSmith Studio : la recherche (sous-graphe orchestrate), puis la génération, la finalisation et l'enregistrement.
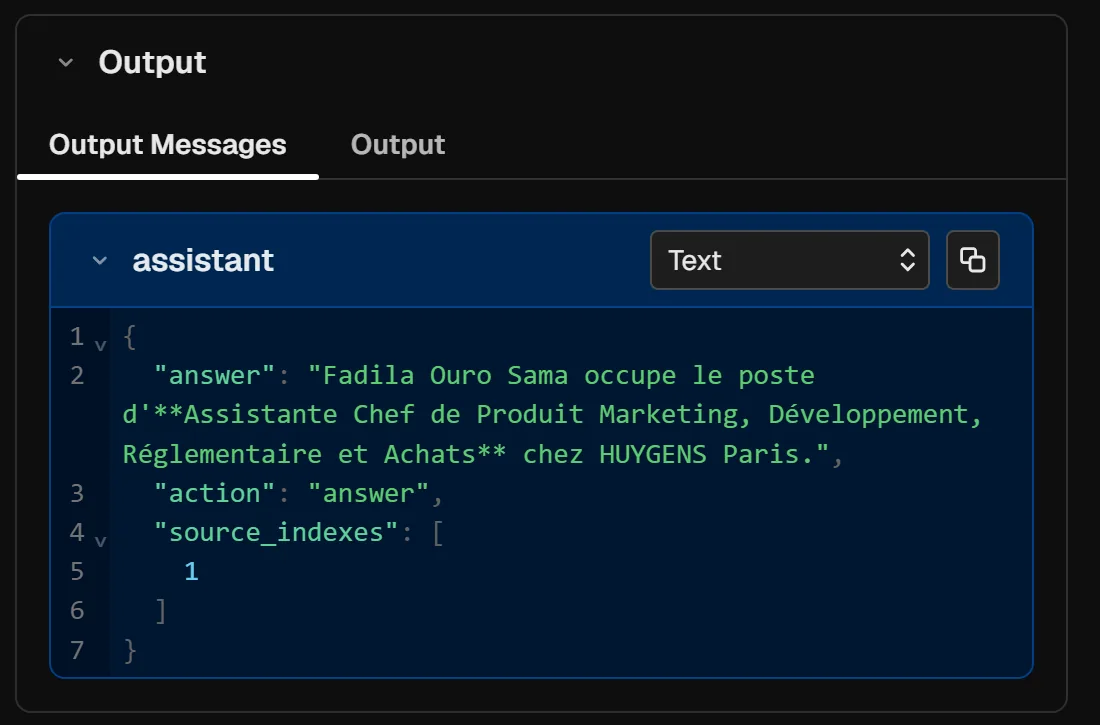
Exemple de sortie JSON produite par le LLM de réponse
Exemple de sortie JSON du LLM de réponse : la réponse, l'action choisie (répondre ou s'abstenir) et les sources utilisées.
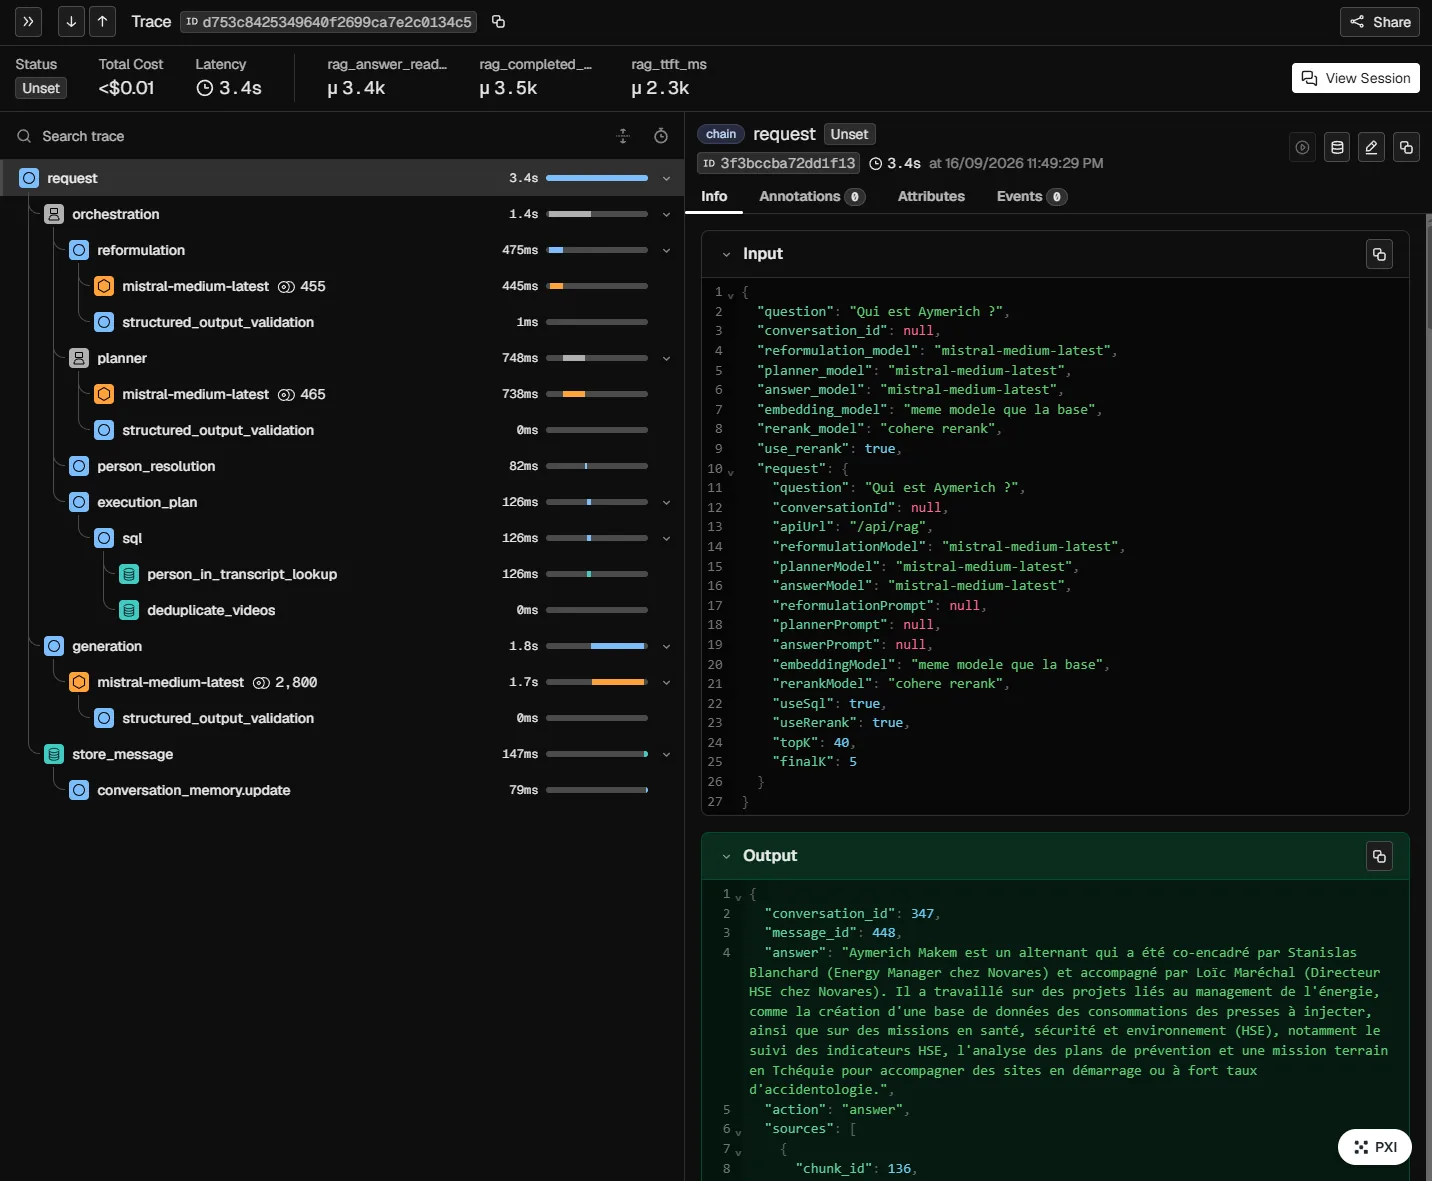
Interface Phoenix affichant les traces OpenTelemetry du pipeline de réponse
Exemple de trace du pipeline dans Phoenix.
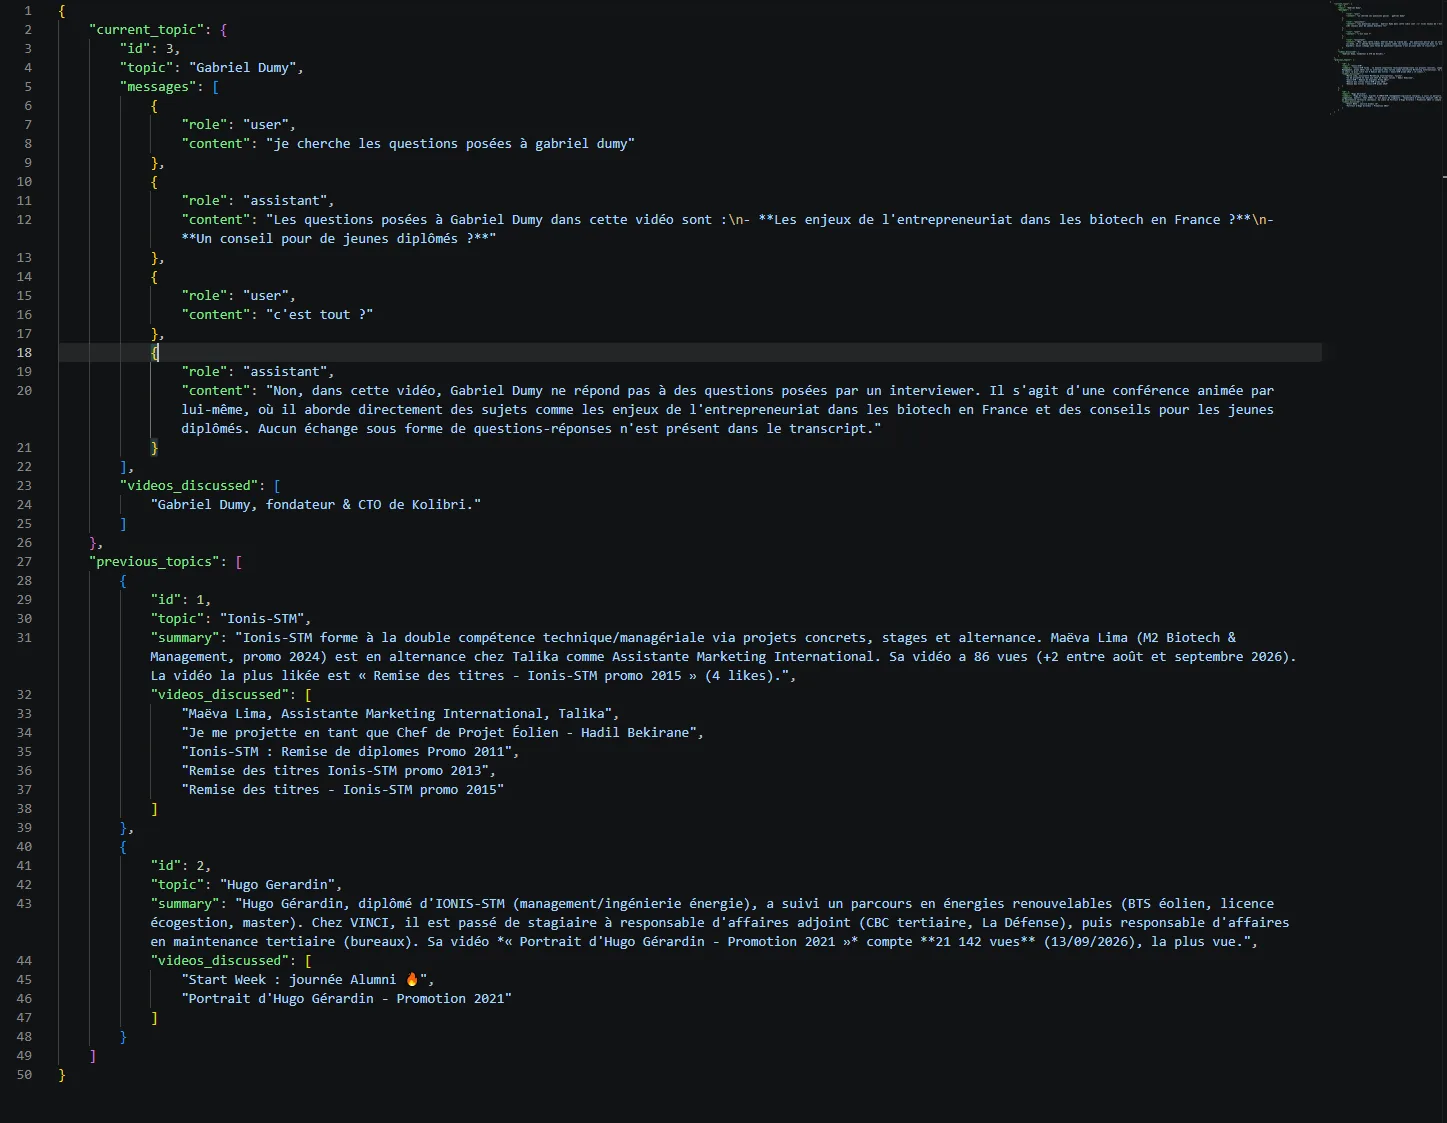
Représentation de la mémoire conversationnelle
Exemple de mémoire conversationnelle envoyée au LLM de reformulation au tour suivant.
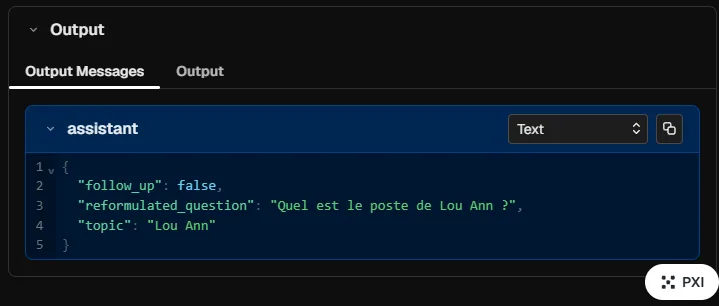
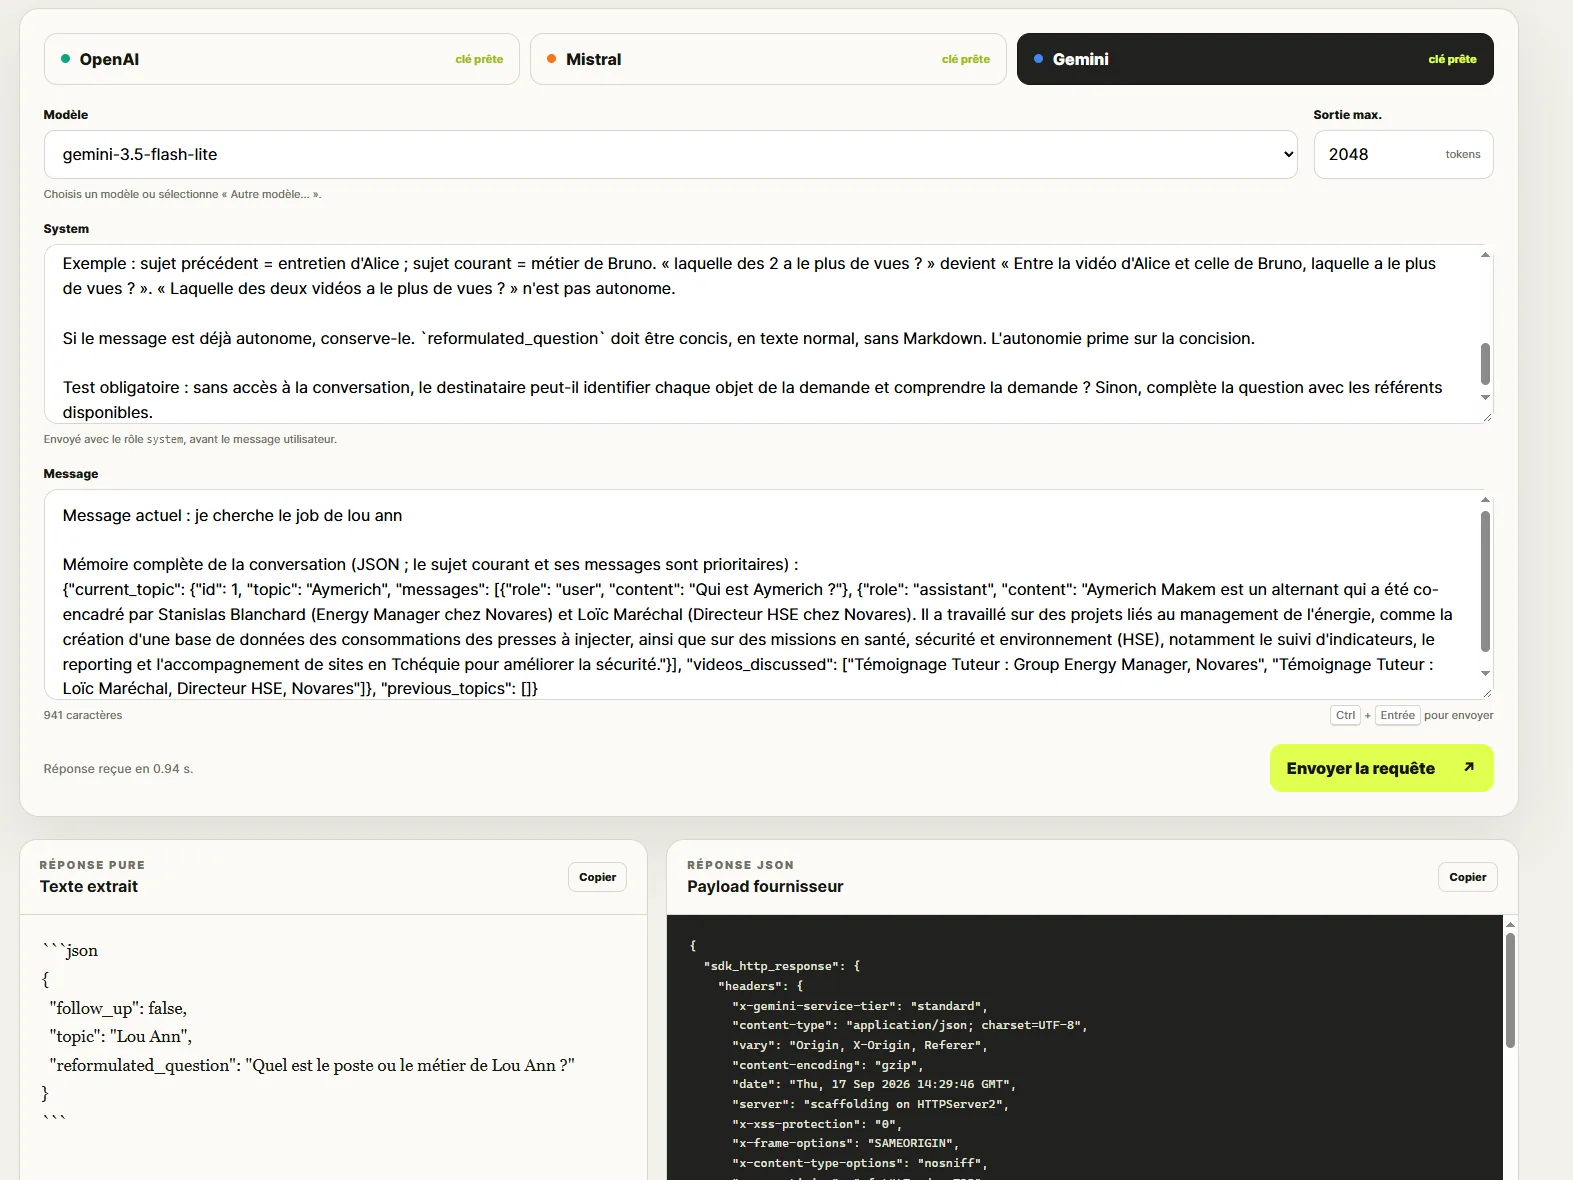
Exemple de sortie du LLM de reformulation
Exemple de sortie du LLM de reformulation : la clé follow_up indique s’il y a un changement de sujet ou non.
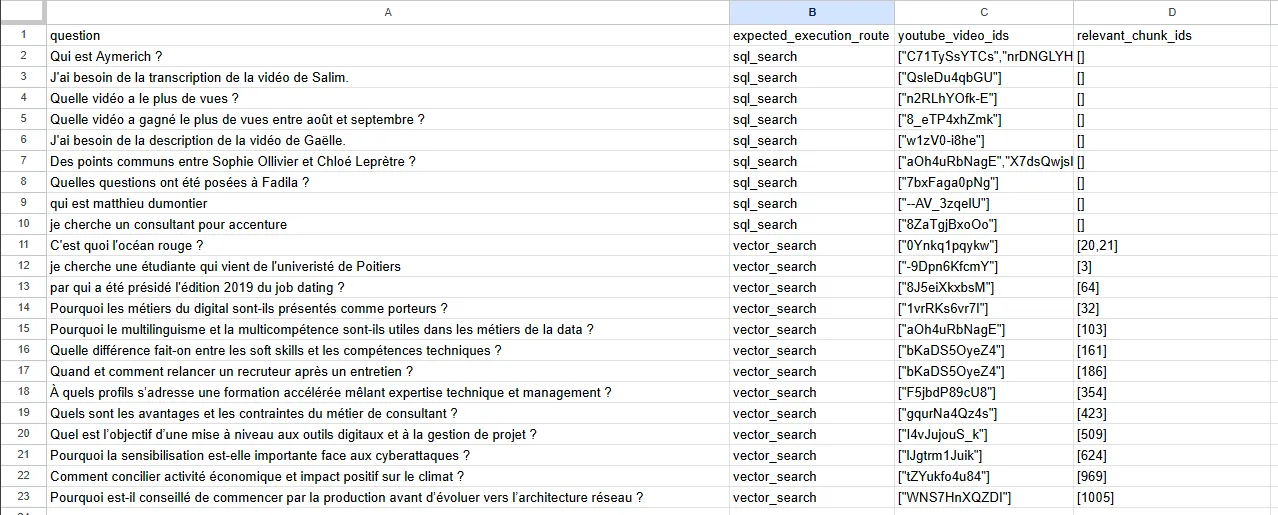
Golden dataset utilisé pour le benchmark Phoenix
Extrait du golden dataset utilisé pour le benchmark Phoenix.
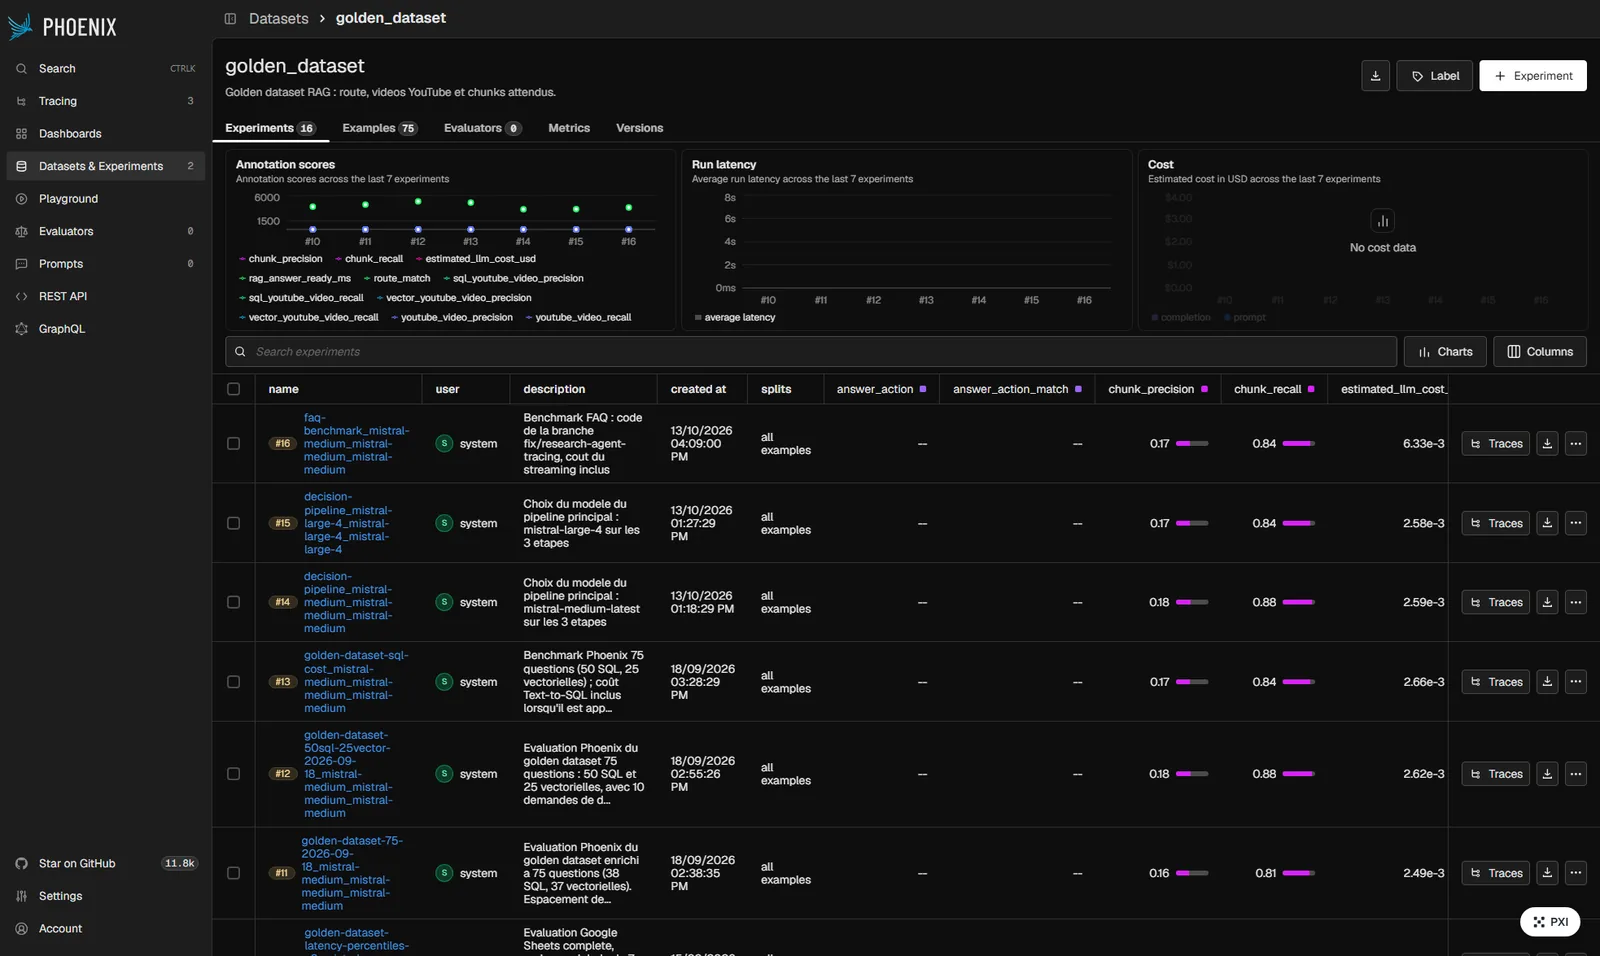
Premier aperçu des résultats du benchmark Phoenix
Résultats du benchmark Phoenix.
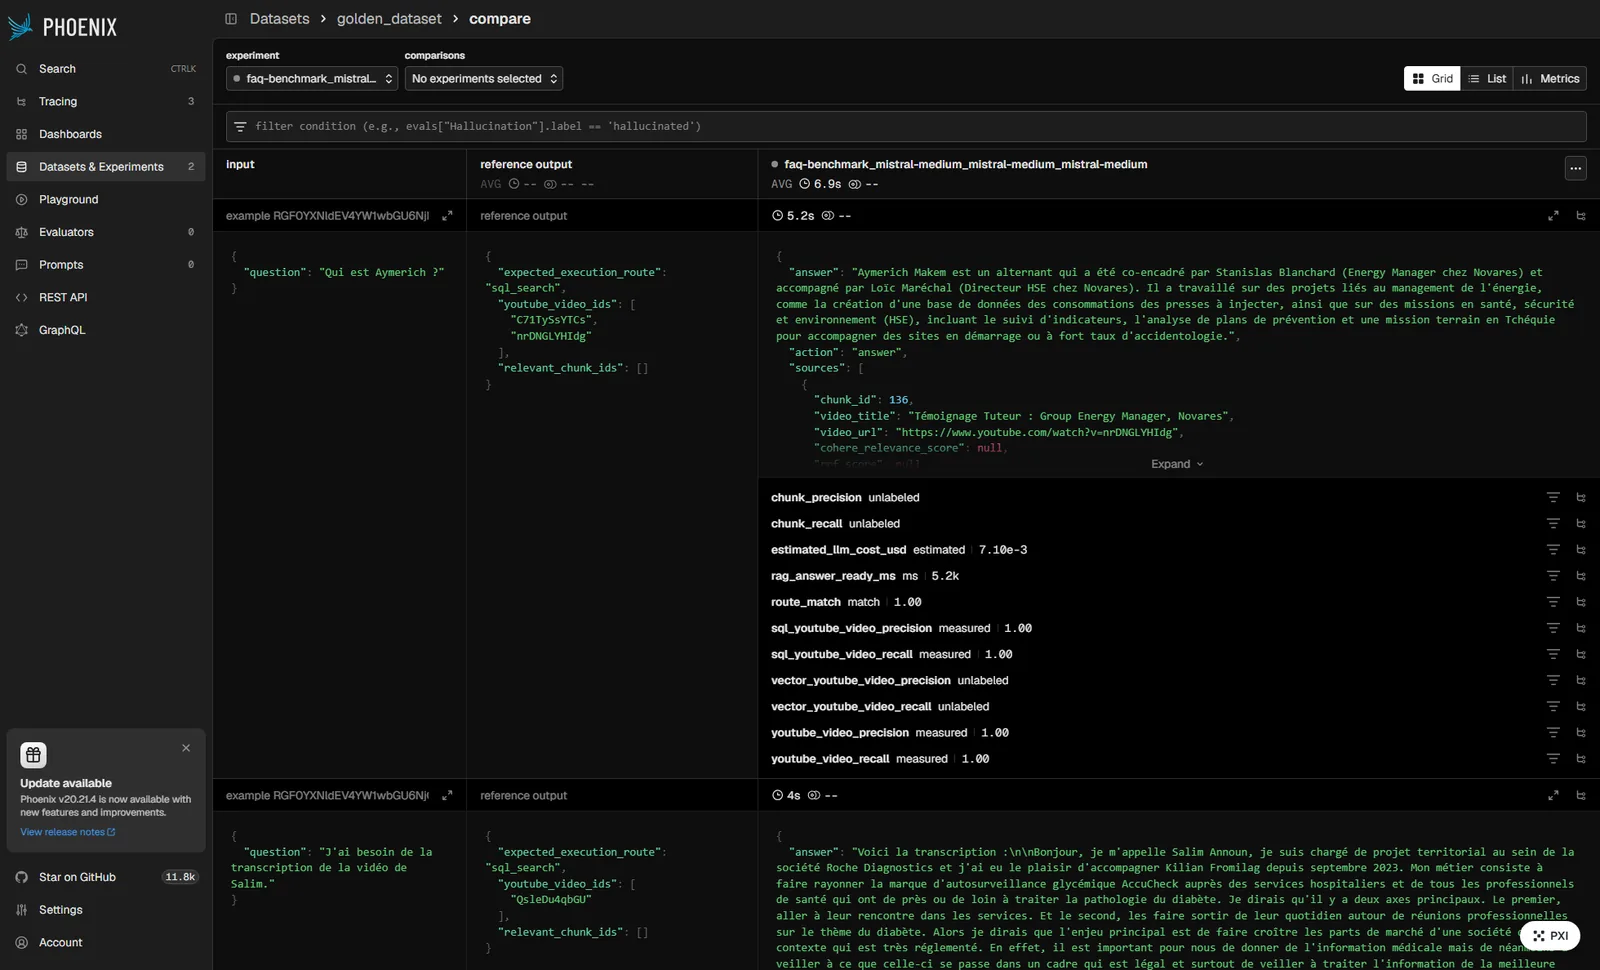
Second aperçu des résultats du benchmark Phoenix
Résultats détaillés du benchmark Phoenix.
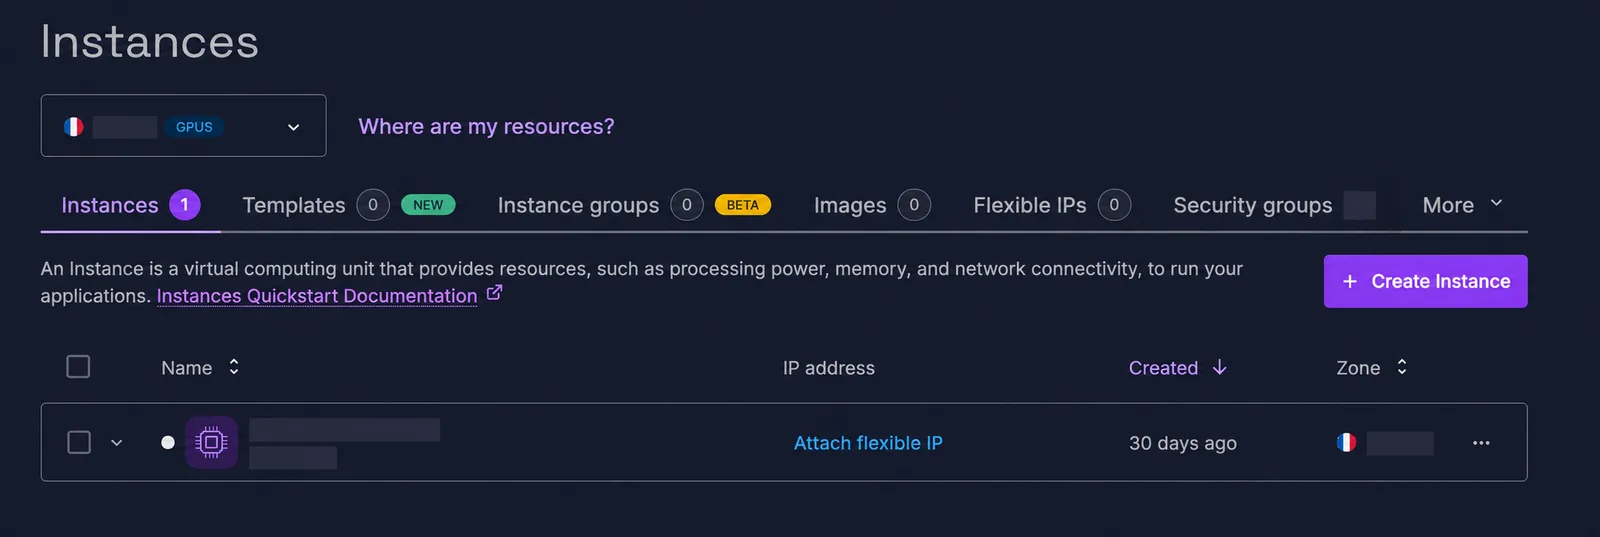
Machine virtuelle GPU Scaleway utilisée pour traiter les vidéos
La VM GPU Scaleway attend un job avant d’être allumée pour traiter les nouvelles vidéos.
Exemple de table de suivi des mises à jour
Exemple de table de suivi de l’état des mises à jour.
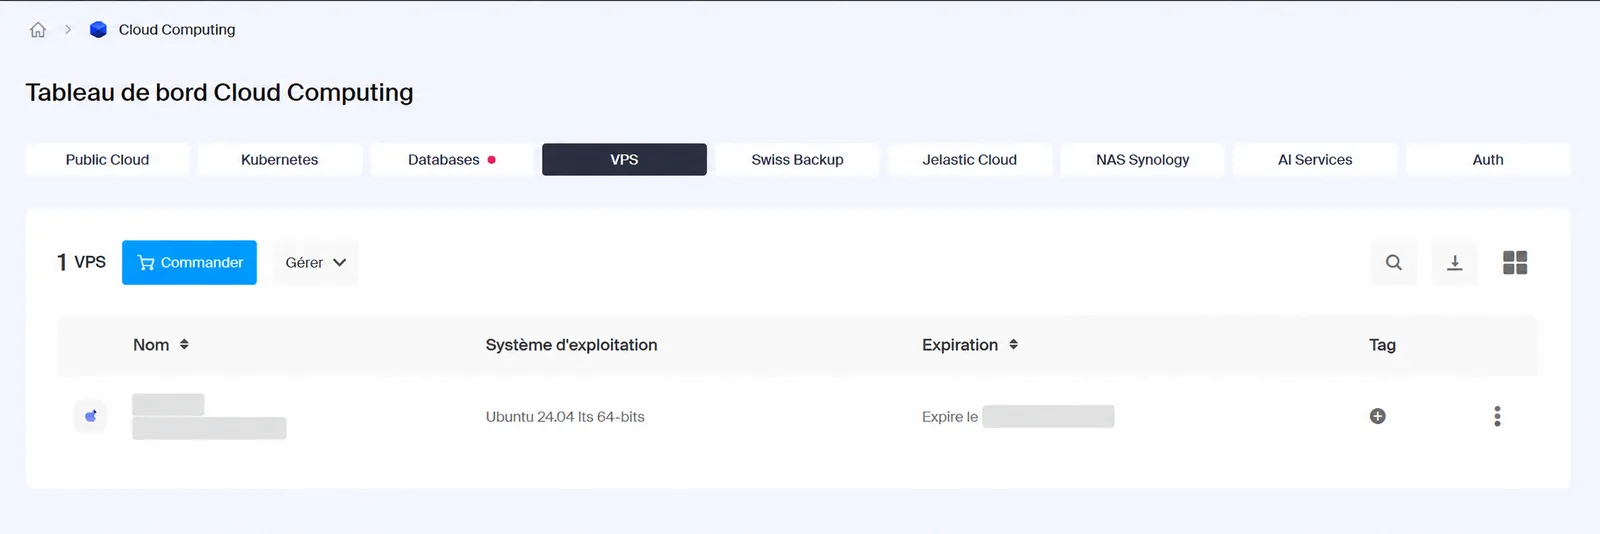
VPS Infomaniak hébergeant le RAG
VPS Infomaniak qui héberge le RAG.
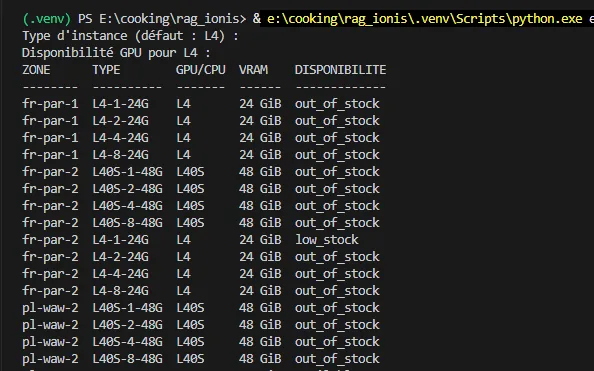
Résultat du contrôle de disponibilité des GPU Scaleway
Exemple de résultat du contrôle de disponibilité des GPU.
Premier screenshot d’un mot-clé détecté par OCR
Exemple d’images envoyées à GPT.
Second screenshot d’un mot-clé détecté par OCR
Exemple d’images envoyées à GPT.
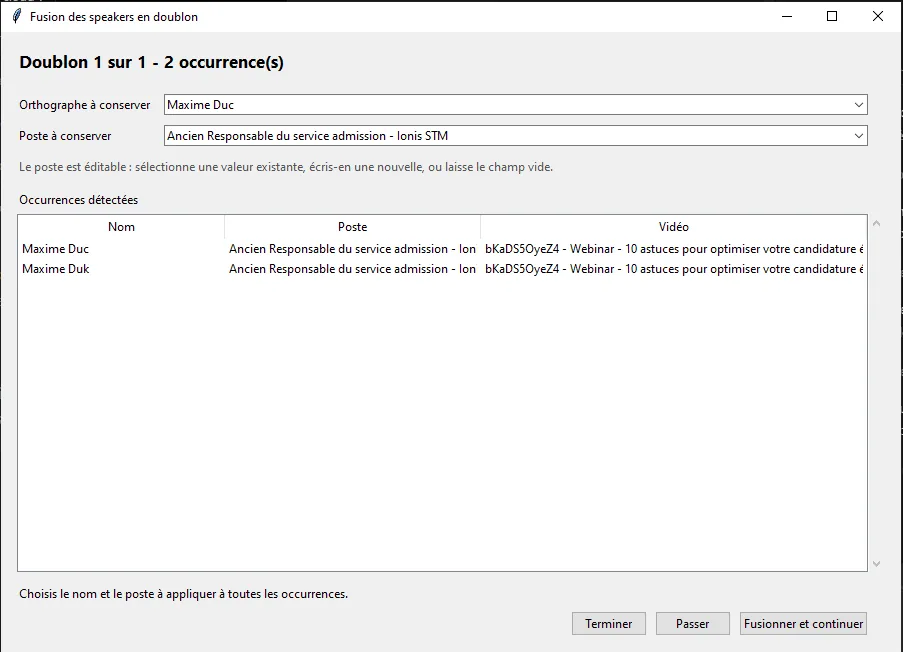
Interface Tkinter proposant la fusion de deux speakers aux orthographes proches
Exemple de rapprochement proposé par l’outil.
Premier exemple de texte détecté dans une vidéo
Premier exemple de texte détecté dans une vidéo.
Deuxième exemple de texte détecté dans une vidéo
Deuxième exemple de texte détecté dans une vidéo.
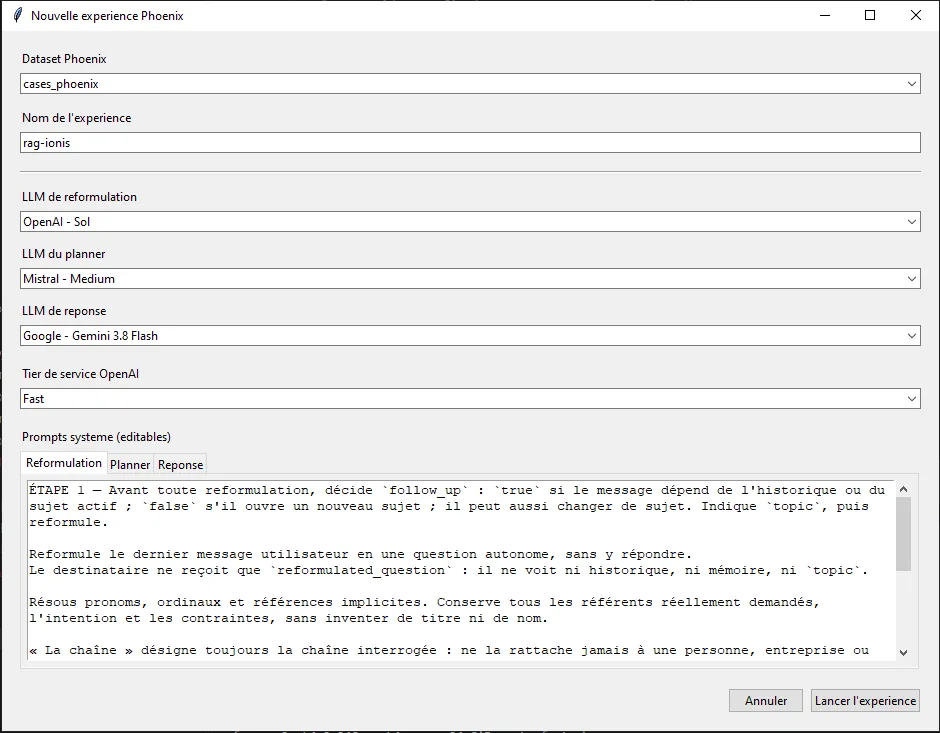
Expérience Phoenix comparant les performances de fournisseurs LLM
Expérience Phoenix exécutée en lot pour comparer les LLM.
Interface de test des payloads envoyés aux fournisseurs LLM
Interface de test des payloads envoyés par les fournisseurs LLM. Ici il est demandé de répondre en texte brut, contrairement au json_schema dans le RAG.
Exemple difficile où les sous-titres sont proches de textes dans le décor
Exemple difficile : les sous-titres sont proches de textes dans le décor.
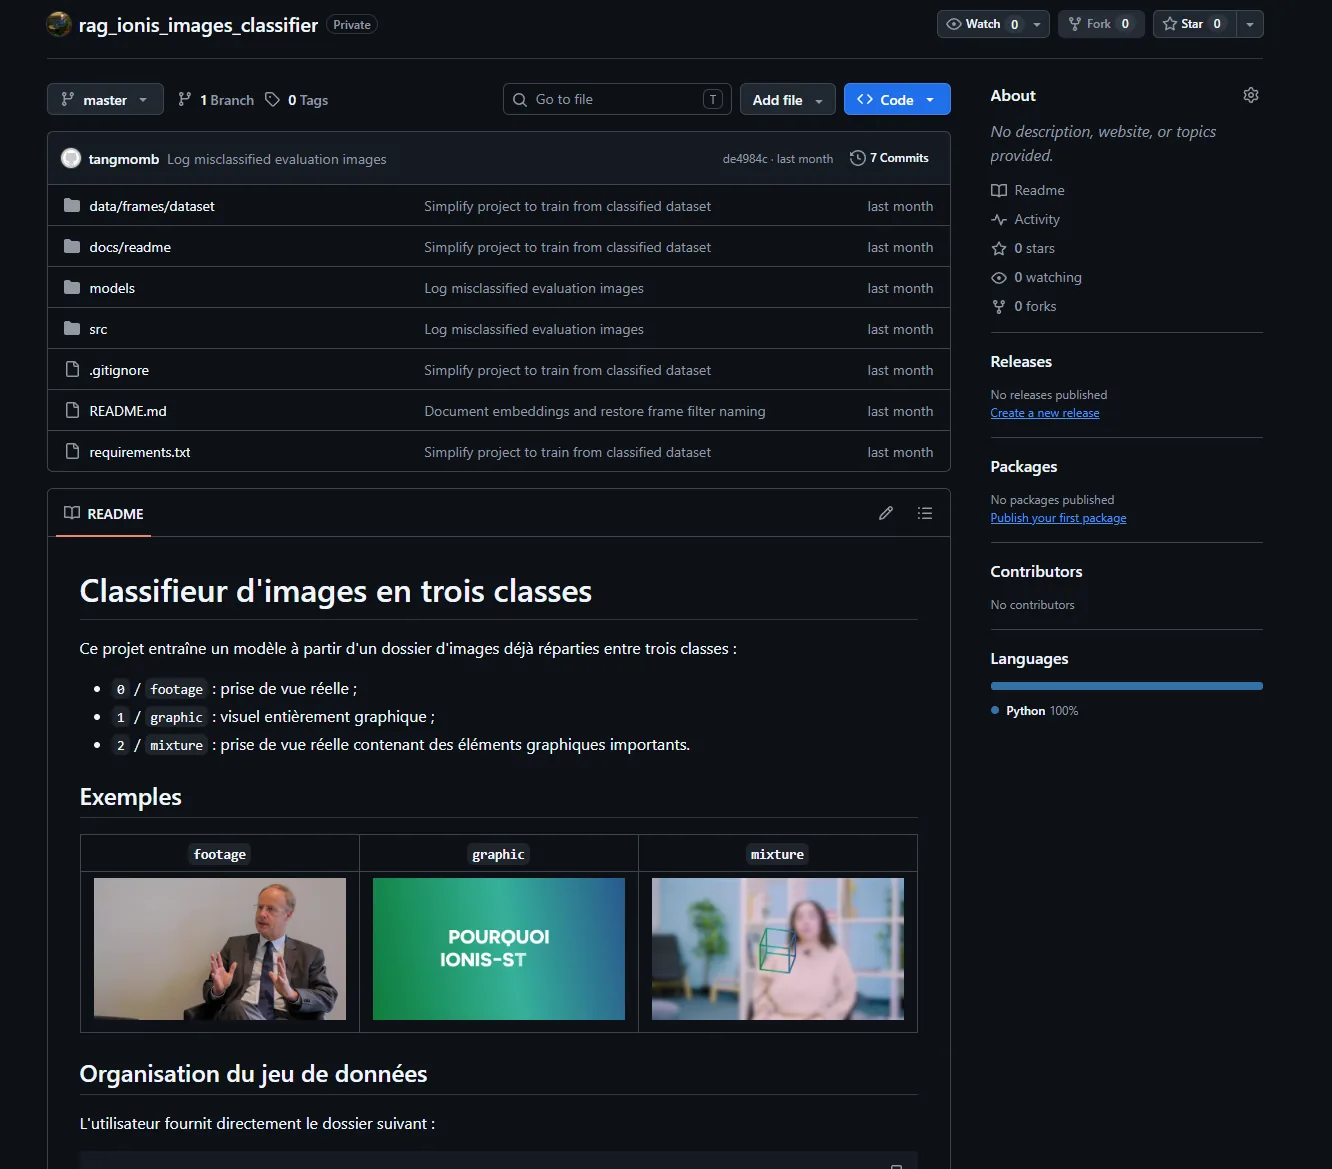
Dépôt GitHub du classifieur d’images
Dépôt GitHub du classifieur d’images.

Projet 03 · Fine-tuning

Fine-tuning LoRA pour le text-to-SQL en français

Des adaptateurs LoRA sur des modèles Qwen 3.5 transforment des questions en français en requêtes SQL, à partir du jeu de données Spider (SQLite).

Statistiques actuelles · execution accuracy sur le jeu de test

2B
29,48 % → 67,44 %
4B
54,26 % → 73,17 %
Meilleur modèle brut (9B)
63,06 %
  • Hyperparamètres. Expériences sur les hyperparamètres LoRA et sur le volume de données d'entraînement.
  • Données synthétiques. 4 jeux de 5 000 exemples synthétiques, validés par un contrôle déterministe et un juge LLM. Le gain maximal mesuré reste faible : +1,26 point.
  • LoRA
  • Qwen 3.5
  • Spider
  • SQLite
  • Python
Avec LoRA, les modèles 2B et 4B dépassent le meilleur modèle brut testé Execution accuracy sur le jeu de test, échelle de 0 à 100 %

2B

Brut
29,48 %
LoRA
67,44 %

4B

Brut
54,26 %
LoRA
73,17 %

9B

Brut
63,06 %

Contact

Mon activité de freelance (vidéo, photo, graphisme, sites web) est sur tanguym.fr.